En la segunda entrada de esta serie vimos el primer pilar de la certificación Cloud Digital Leader, la transformación digital, toca ahora meterse con el segundo pilar, la transformación de datos, uno de los más extensos del examen porque cubre todo el recorrido que hace un dato desde que nace hasta que se convierte en una decisión.
Como ya vimos, la transformación digital se apoya fuertemente en los datos, y este pilar profundiza justamente en eso, de dónde vienen, cómo se recopilan, cómo se procesan y almacenan, y cómo terminan convertidos en análisis que ayudan a tomar decisiones. Vamos a recorrer cada una de estas etapas con ejemplos prácticos.
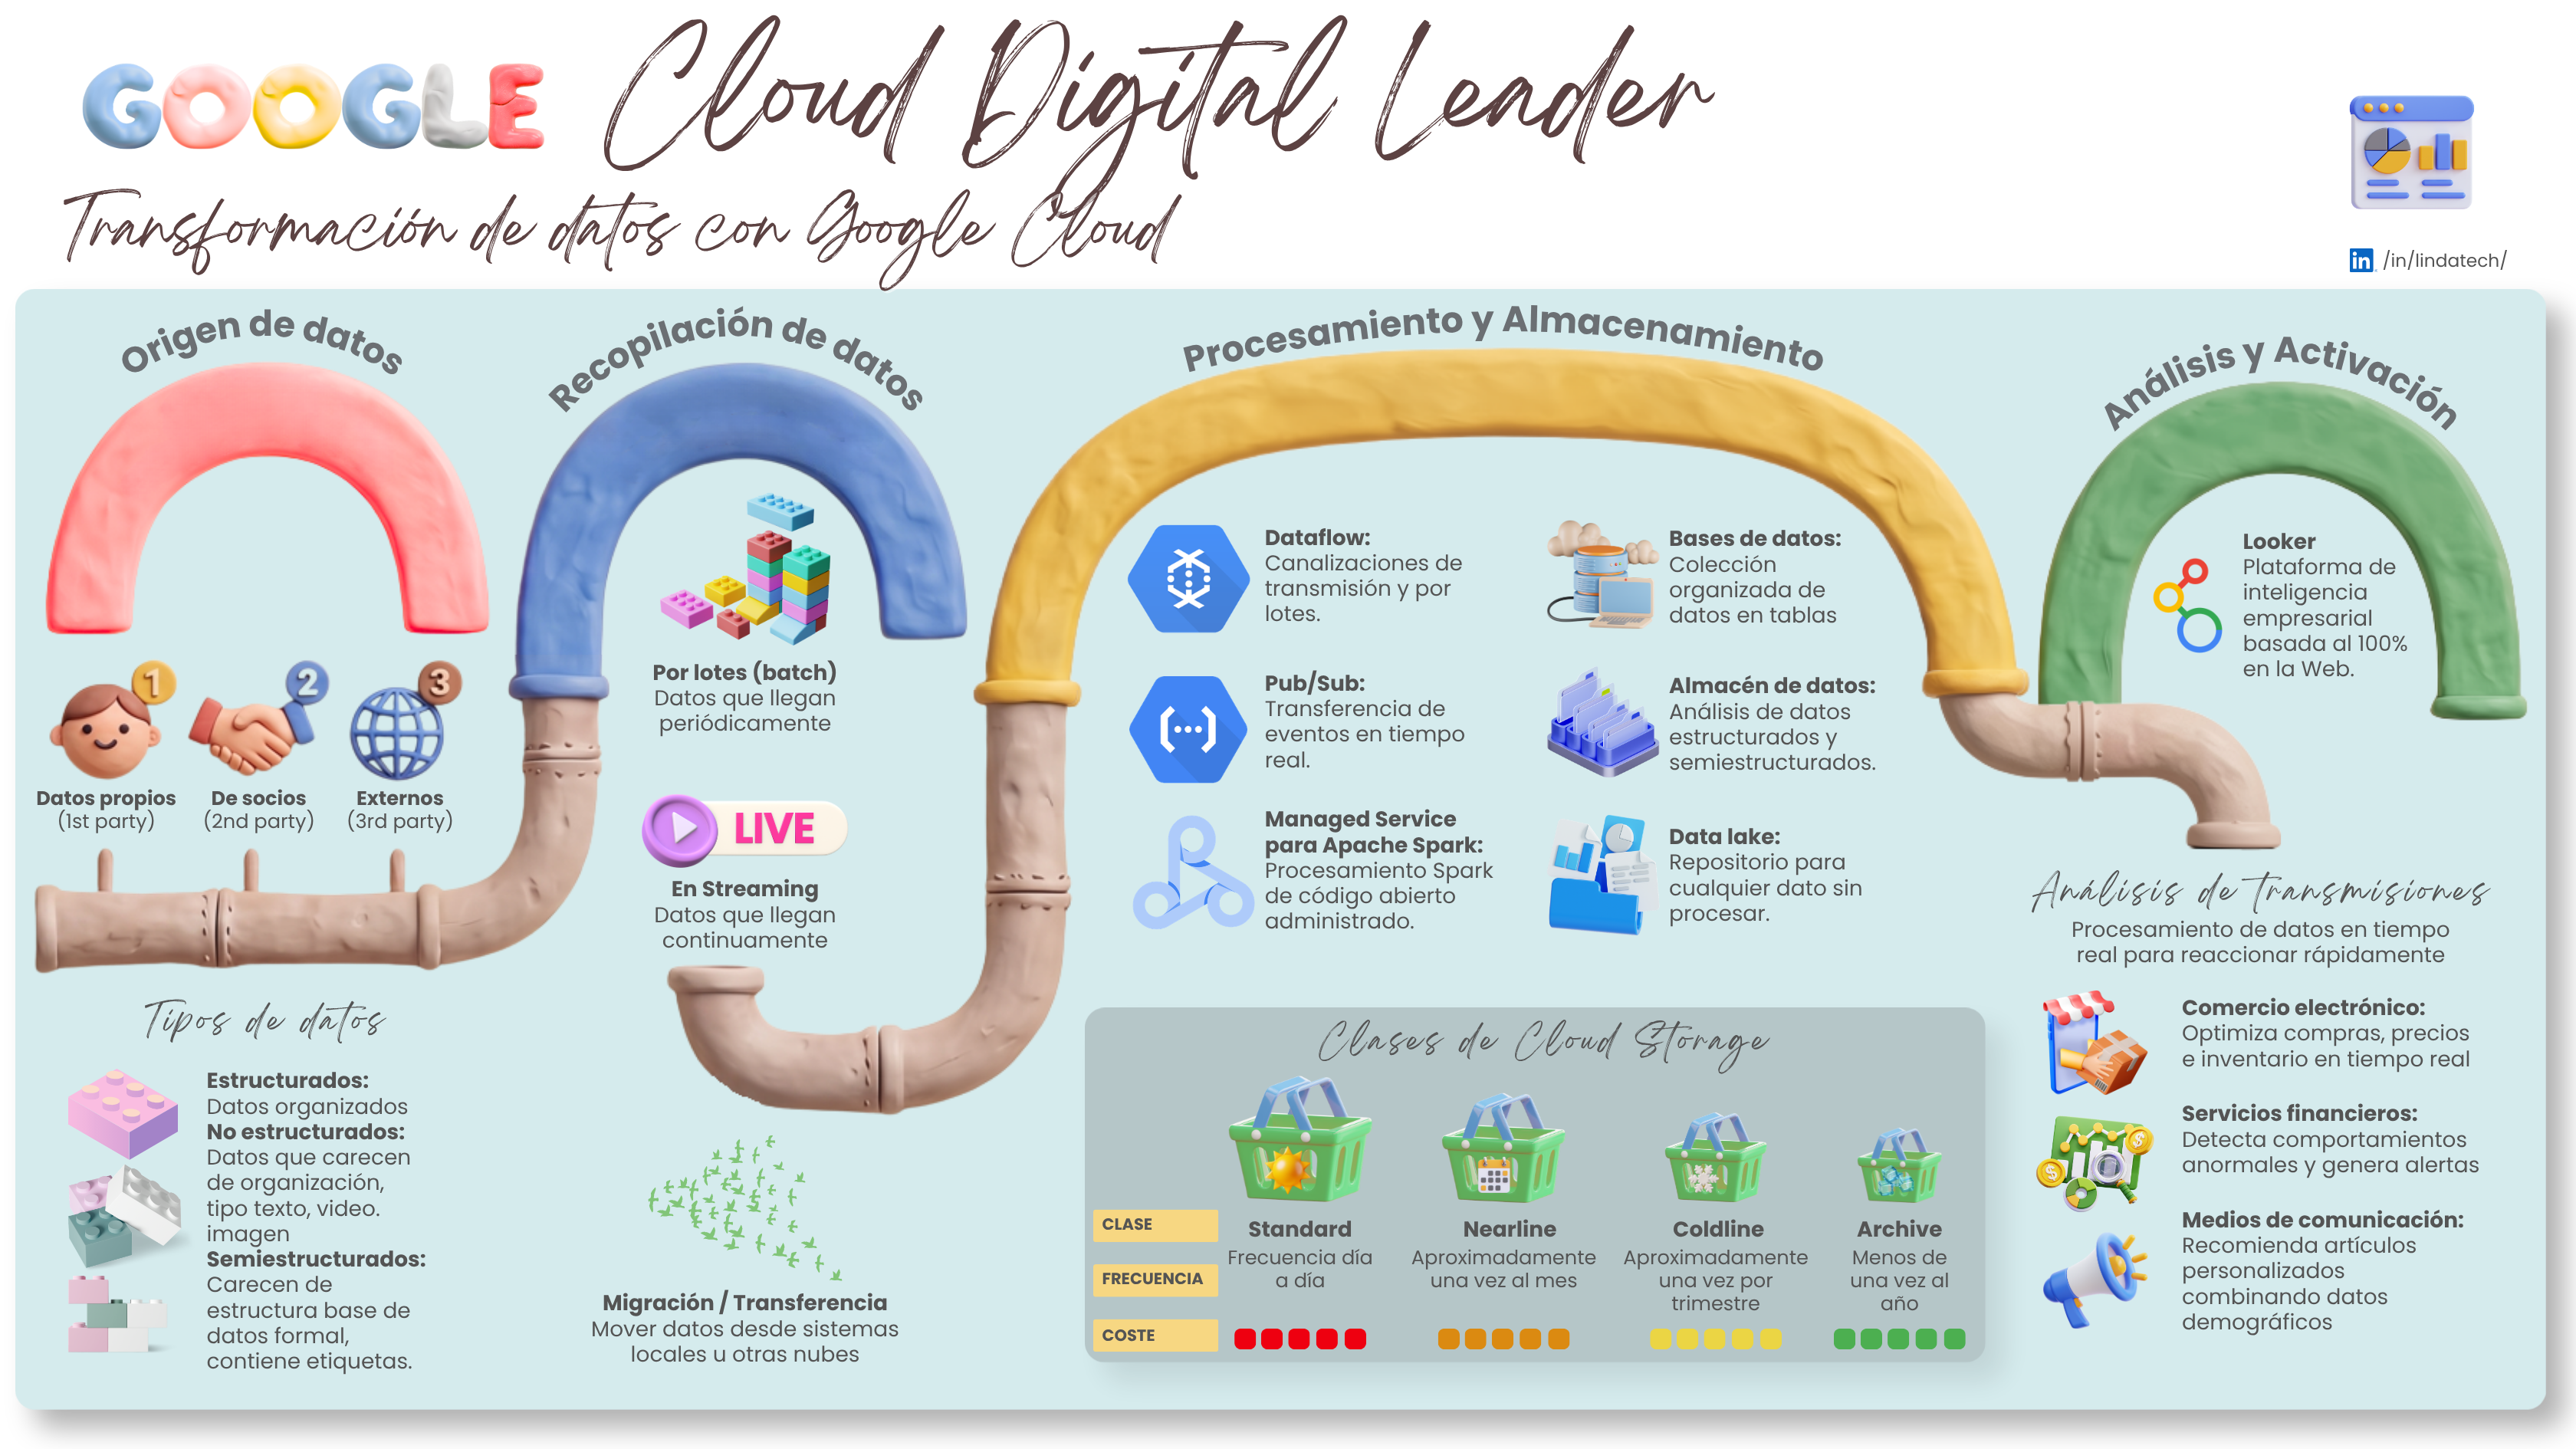
Origen de datos
Antes de recopilar cualquier dato conviene saber de dónde viene, porque no toda la información que maneja una empresa nace de la misma fuente ni tiene el mismo nivel de cercanía con el cliente.
- Datos propios (1st party): son los datos que una empresa recoge directamente de sus propios clientes o usuarios. Por ejemplo, el historial de compras de los clientes de una tienda online, registrado en su propia base de datos.
- De socios (2nd party): son los datos propios de otra empresa que esta comparte contigo como parte de una alianza. Por ejemplo, una aerolínea que comparte con un hotel los datos de los viajeros que reservaron un vuelo, para que el hotel les ofrezca un paquete combinado.
- Externos (3rd party): son datos que se compran o se obtienen de terceros que no tienen relación directa con tus clientes. Por ejemplo, una empresa que compra datos demográficos de toda una región a una agencia especializada en recolectar y vender ese tipo de información.
Para verlo aplicado a un caso concreto, imagina un gimnasio que quiere conocer mejor a sus socios actuales y también a los clientes que todavía no se han inscrito, este negocio podría tener el siguiente origen de datos:
- Sus datos propios serían el historial de asistencia y los planes contratados por sus socios, registrados en su propio sistema de gestión, por ejemplo Mindbody o Glofox.
- Sus datos de socios los conseguiría, por ejemplo, de una alianza con una aplicación de nutrición como MyFitnessPal, que le comparte los hábitos alimenticios de los usuarios que también entrenan en el gimnasio.
- Y sus datos externos serían los datos de audiencia e intereses que le ofrecen plataformas como Google Ads o Meta Ads a través de sus campañas publicitarias, para decidir a qué público dirigirse o si conviene abrir una segunda sede cerca de cierta zona.
Tipos de datos
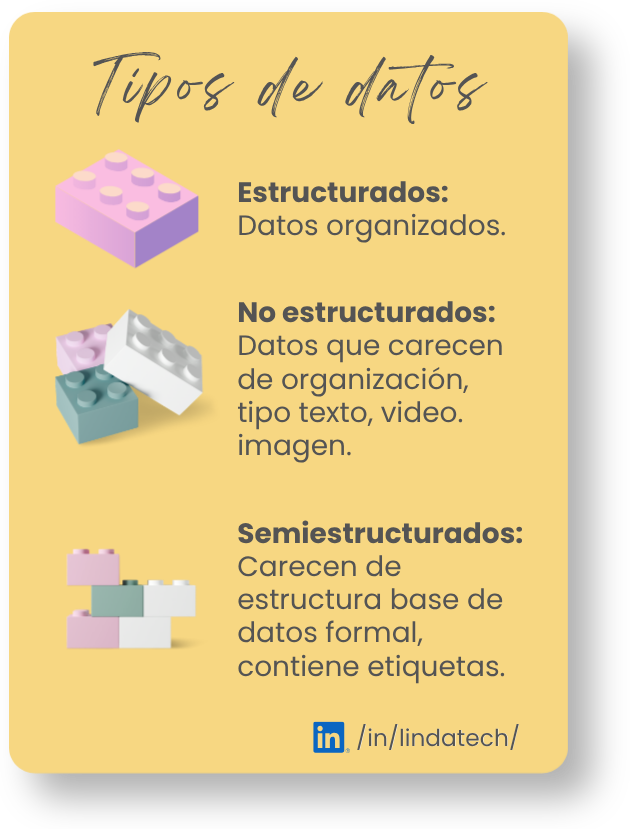
Además de saber de dónde vienen, conviene identificar qué forma tienen esos datos, porque de eso depende cómo se van a poder almacenar y analizar después.
- Estructurados: datos organizados en un formato fijo, con filas y columnas claramente definidas. Por ejemplo, una hoja de cálculo con los pedidos de una tienda, donde cada columna es siempre el mismo dato, fecha, cliente, producto y monto.
- No estructurados: datos que no tienen ninguna organización predefinida, como texto libre, video o imágenes. Por ejemplo, los comentarios que dejan los clientes en una reseña, cada uno con su propio formato y longitud, sin ninguna estructura fija detrás.
- Semiestructurados: datos que no encajan en una base de datos tradicional, pero que sí contienen metadatos, es decir etiquetas que dan algo de orden. Por ejemplo, un correo electrónico no tiene columnas como una tabla, pero sí trae etiquetas claras como remitente, asunto y fecha, que ayudan a organizarlo aunque el cuerpo del mensaje sea texto libre.
Recopilación de datos
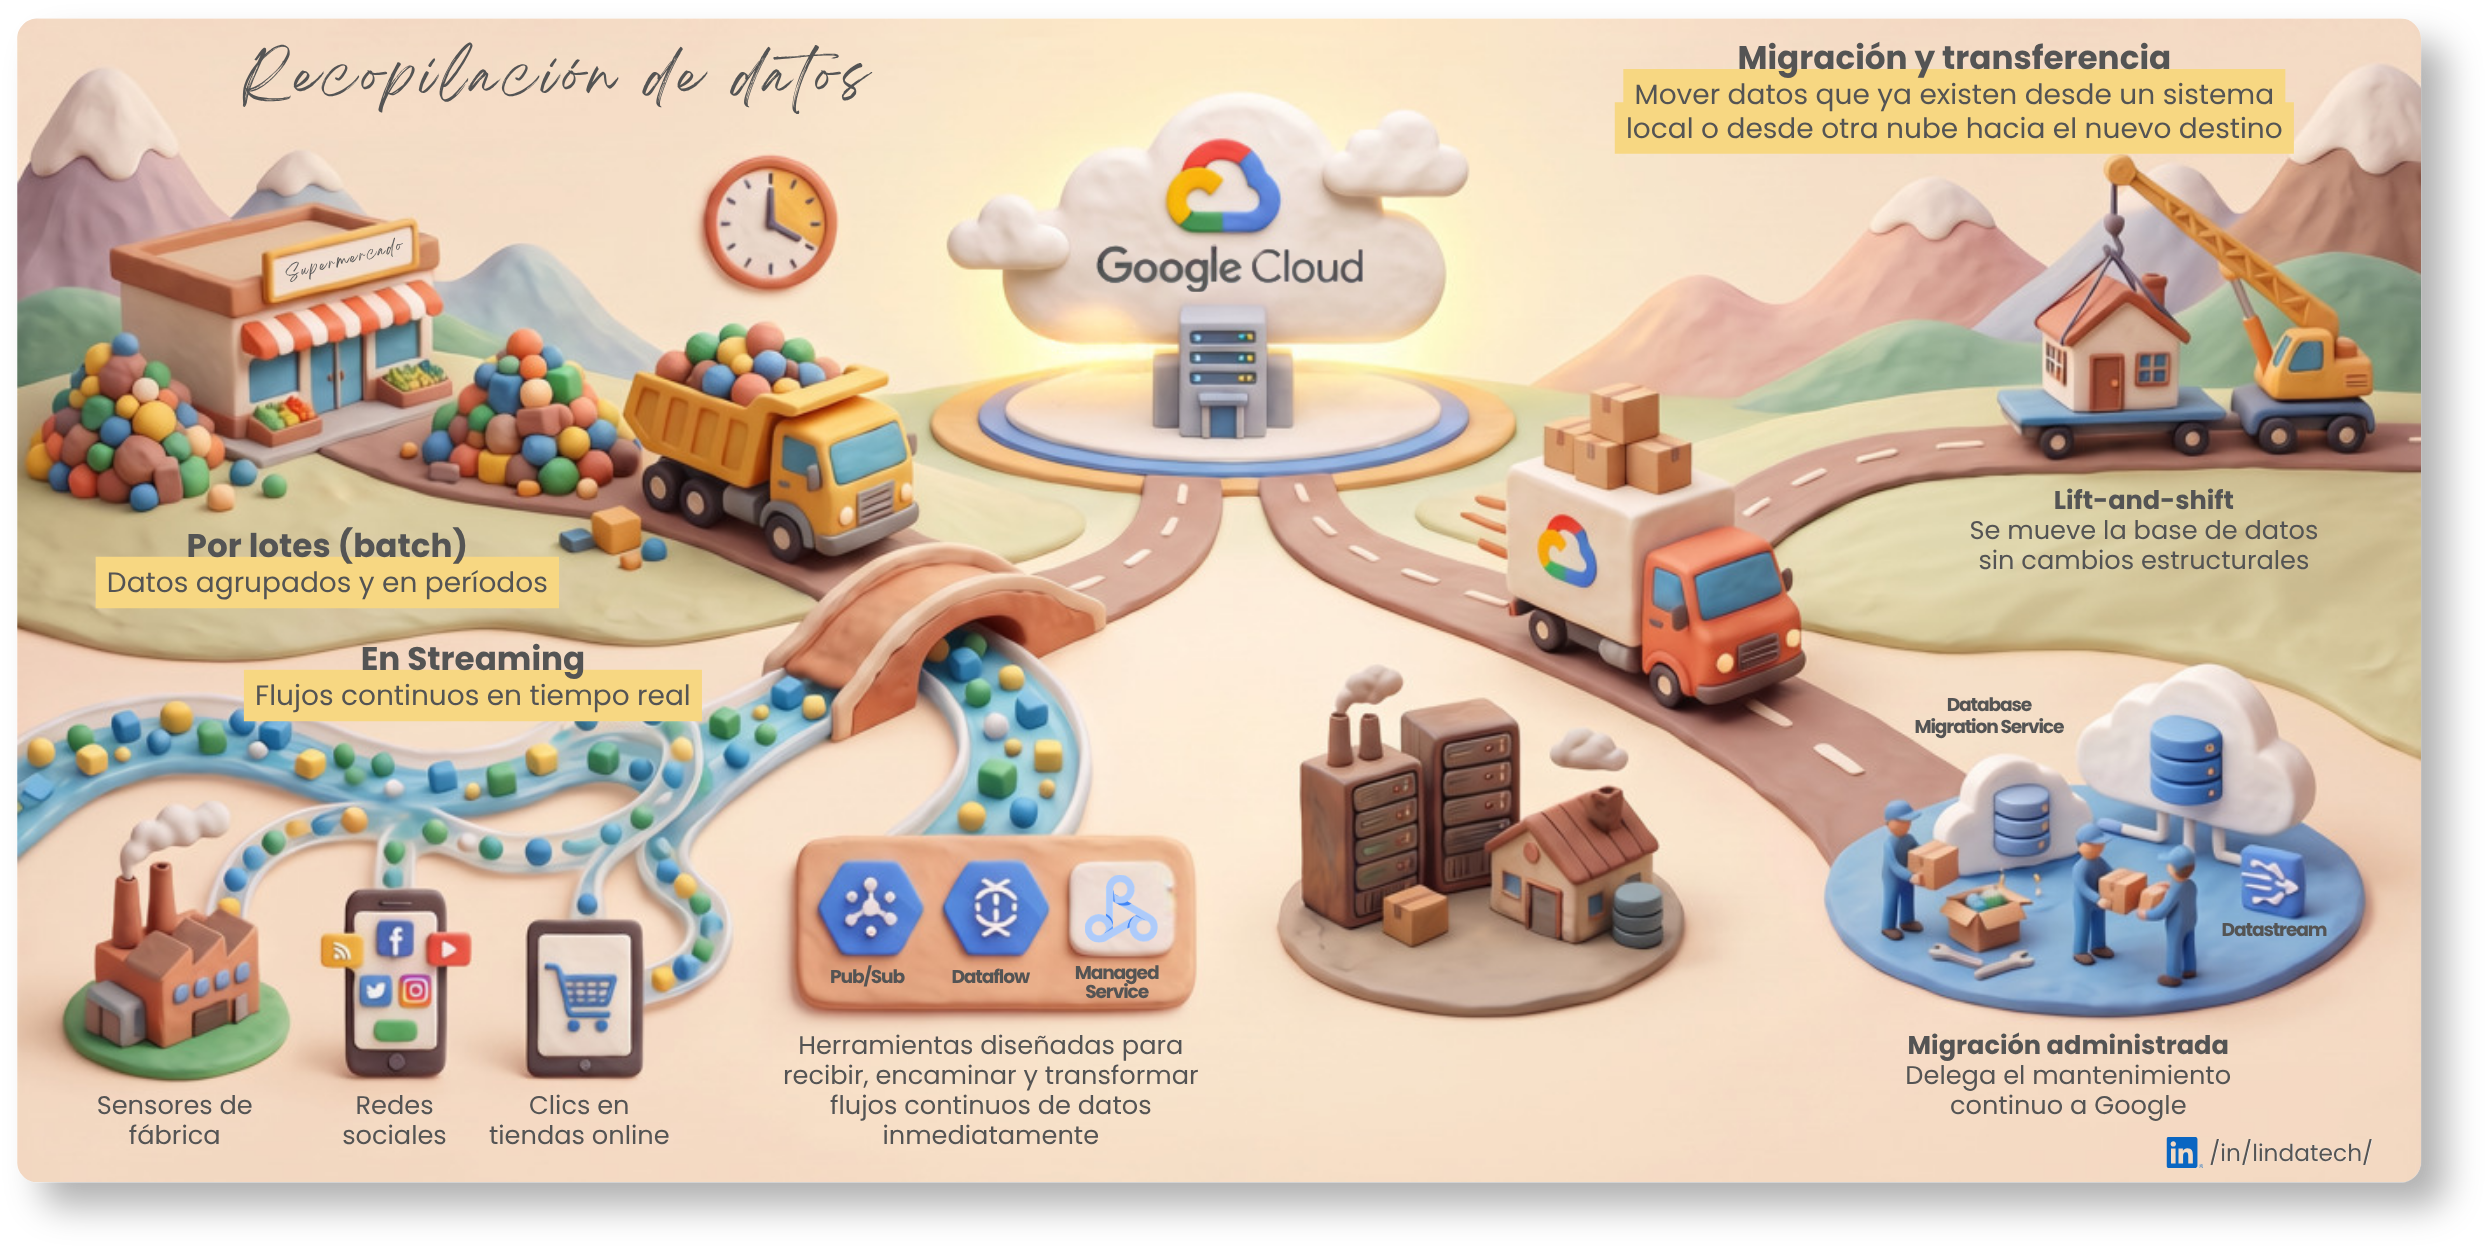
Una vez identificado el origen, toca decidir cómo van a llegar esos datos hasta donde se van a procesar. Tradicionalmente, los datos se recopilaban y procesaban en lotes, de manera retrasada, pero la nube permite además la recopilación continua y en tiempo real. Entonces, las opciones para recopilar o ingerir datos son las siguientes:
Por lotes (batch)
Los datos llegan de forma periódica, agrupados, en vez de en el momento en que se generan. Por ejemplo, un supermercado que al cierre de cada día sube todas las ventas del día a la nube en un solo envío, en vez de mandarlas venta por venta.
En streaming
Los datos se recopilan en pequeños paquetes y flujos continuos, a medida que van ocurriendo, sin esperar a agruparlos. Estas fuentes de transmisión pueden venir de distintos lugares, por ejemplo sensores de maquinaria en una fábrica, publicaciones nuevas en redes sociales, la actividad de los usuarios dentro de una aplicación móvil, o los clics que va dejando un cliente mientras navega por una tienda online.
Para recopilar y mover esos flujos continuos, Google Cloud ofrece varias tecnologías. Algunas ya las vamos a ver también como herramientas de procesamiento más adelante, pero aquí cumplen específicamente el papel de recibir y encaminar los datos apenas llegan: Pub/Sub, Dataflow y Managed Service para Apache Spark.
Migración o transferencia
Mover datos que ya existen desde un sistema local o desde otra nube hacia el nuevo destino. Por ejemplo, una empresa que decide llevar su base de datos histórica desde sus propios servidores hacia Google Cloud, o desde otro proveedor de nube, algo parecido a lo que vimos en el bloque de múltiples nubes de la entrada anterior.
Cuando lo que se migra es específicamente una base de datos, las organizaciones suelen elegir entre dos caminos. Uno es una migración lift and shift, que mueve la base de datos tal como está, pensada para minimizar las interrupciones del negocio durante el traslado. El otro es una migración completamente administrada, apoyada en herramientas de Google Cloud como Database Migration Service y Datastream, pensada para las empresas que además de mover los datos quieren descargarse del mantenimiento continuo de esa base de datos. Es parecido a mudarte de casa, lift and shift es llevarte los muebles tal como están sin tocar nada, mientras que la migración administrada es contratar a alguien que además de mudarte los muebles se encarga de mantenerlos en buen estado después.
Procesamiento de datos
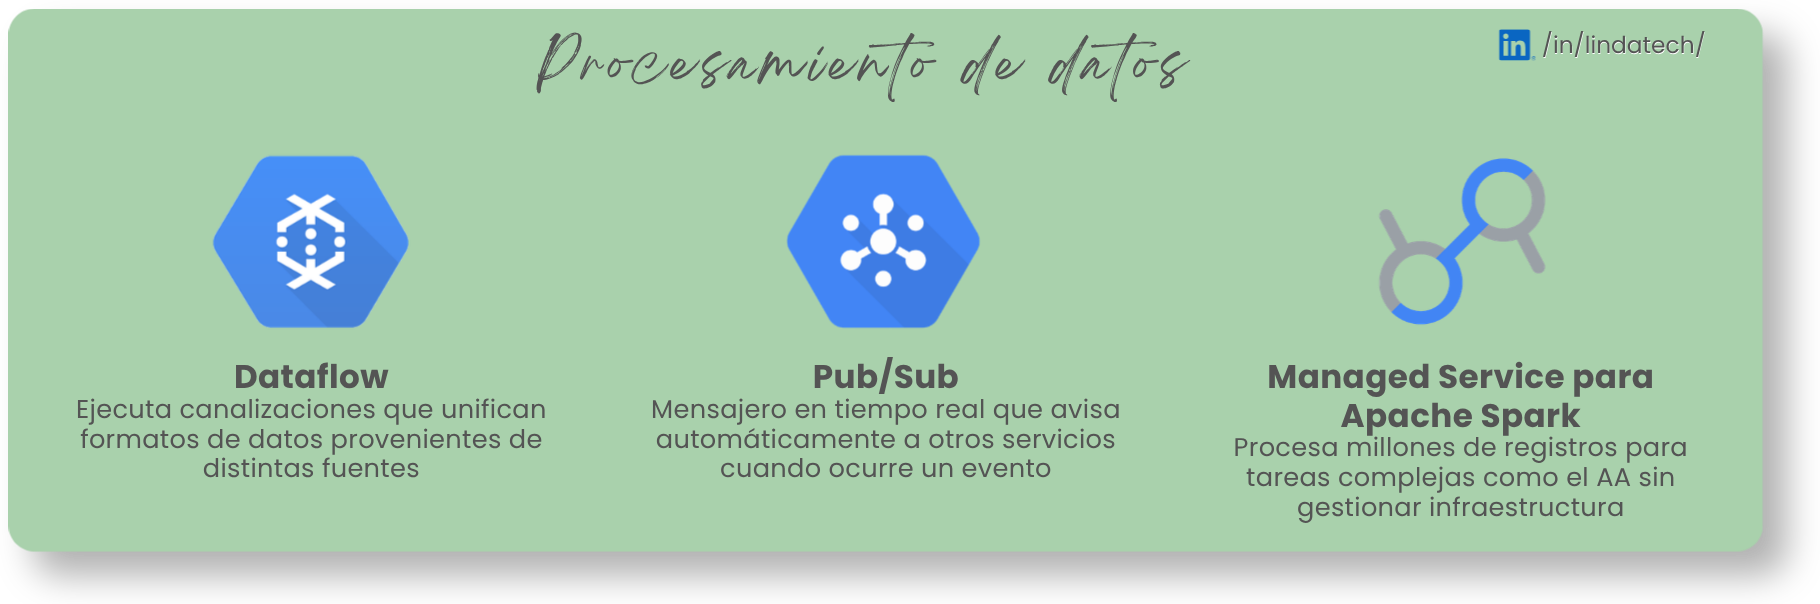
Una vez que los datos llegan, hay que transformarlos antes de que estén listos para guardarse y analizarse. Estas tres tecnologías ya aparecieron en la etapa de recopilación cumpliendo el papel de recibir y encaminar los datos, aquí profundizamos en su función de procesamiento propiamente dicha. Estas tecnologías son Dataflow, Pub/Sub y Managed Service para Apache Spark.
Dataflow
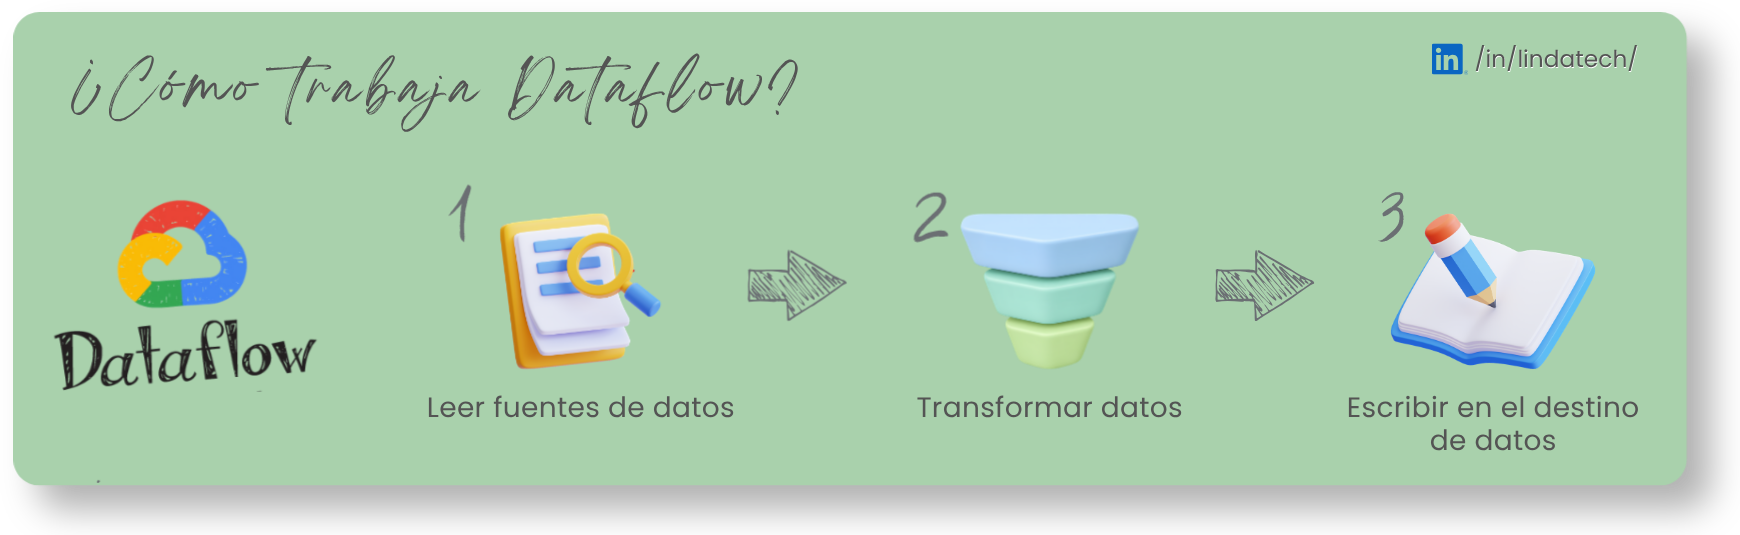
Servicio sin servidor que ejecuta canalizaciones de datos, tanto en streaming como por lotes, limpiando y transformando los datos en su recorrido. A este proceso de extraer, transformar y cargar datos se le conoce como ETL. Toda canalización de Dataflow sigue tres pasos, lee los datos desde un origen, que puede ser un archivo, Bigtable, BigQuery o Pub/Sub, los transforma, y los escribe en un destino, que puede ser ese mismo tipo de lugar. Por ejemplo, una tienda online que necesita limpiar y unificar el formato de los pedidos que llegan desde su web, su aplicación móvil y su tienda física antes de analizarlos juntos, leer esos pedidos sería el primer paso, unificarlos el segundo, y guardarlos ya limpios en BigQuery el tercero.
Pub/Sub
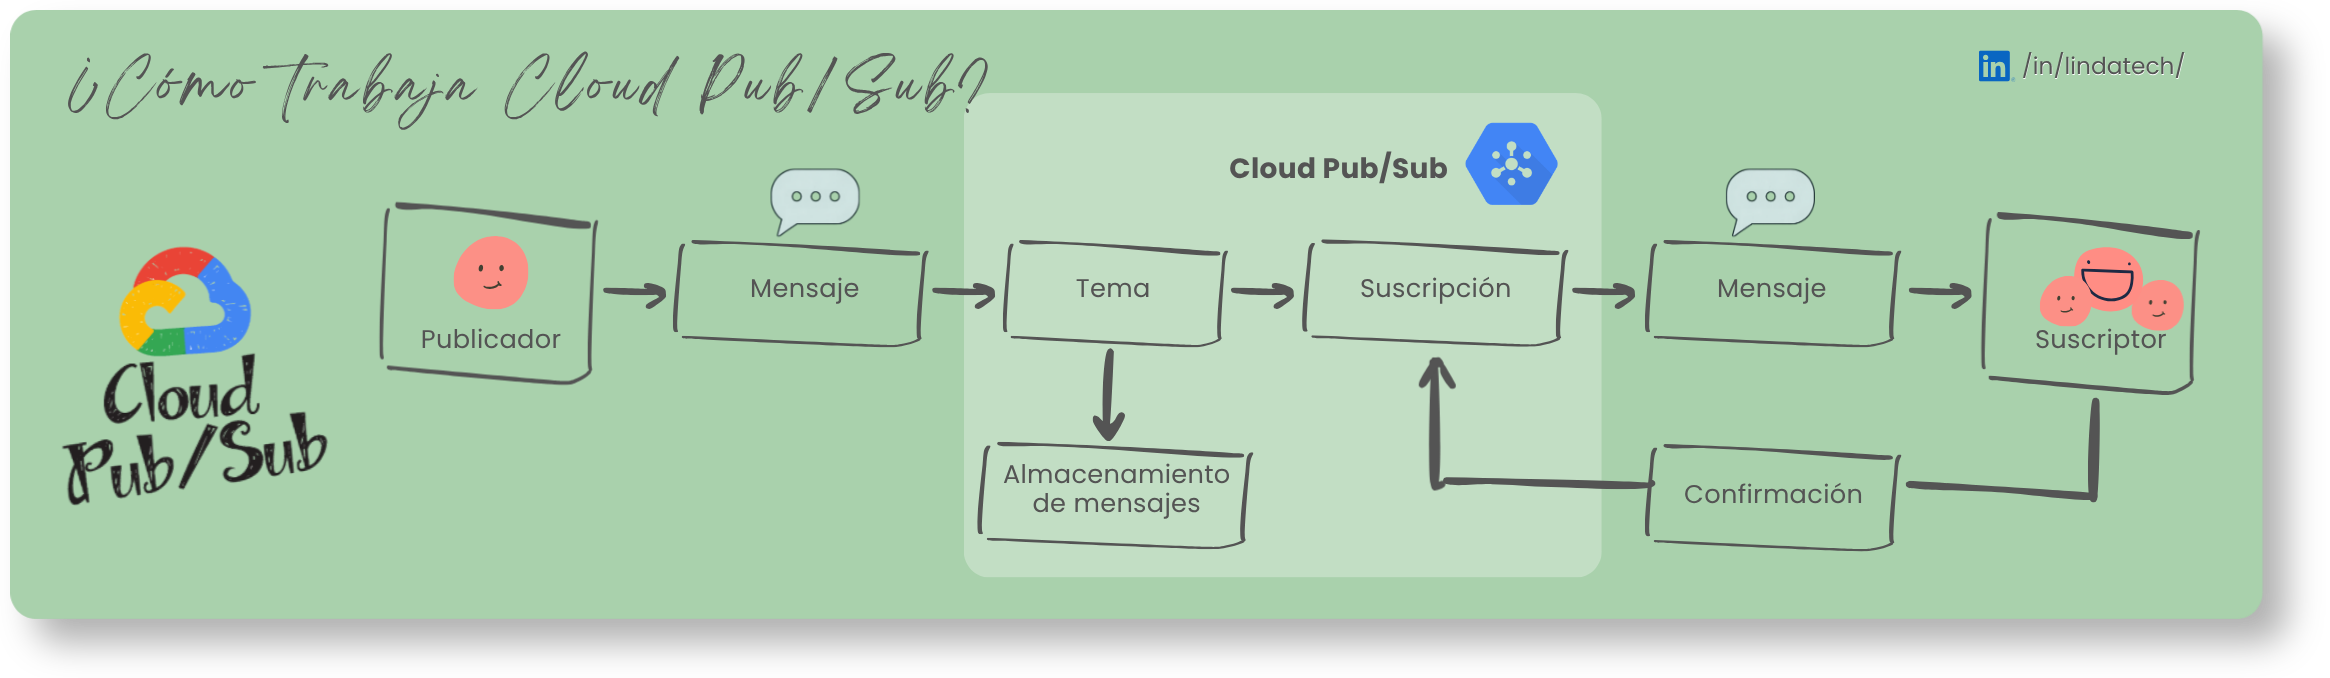
Servicio asíncrono que transfiere eventos entre sistemas en tiempo real, funciona como un mensajero que avisa a distintos sistemas apenas ocurre algo. Por dentro, funciona así: quien publica un mensaje lo envía a un tema, Pub/Sub lo guarda ahí, y cada sistema suscrito a ese tema lo recibe y confirma que lo recibió, para que Pub/Sub sepa que ya se entregó. Por ejemplo, cuando un cliente hace un pedido, ese pedido se publica en un tema, y los sistemas de inventario, facturación y envío, cada uno suscrito a ese mismo tema, lo reciben al mismo tiempo y confirman su recepción, sin que ninguno tenga que ir a consultar si hay algo nuevo.
Entre las características y ventajas de Pub/Sub destacan:
- Proporciona mensajería e ingesta de eventos para analítica en tiempo real.
- Es serverless, escala automáticamente y aprovisiona recursos según sea necesario.
- Permite publicar y suscribirse a eventos independientemente de la ubicación geográfica.
- Puedes crear hasta 10.000 aplicaciones suscriptoras por tema, además, ofrece capacidad y facturación independientes para publicadores y suscriptores.
- Admite el modelo de entrega push y es especialmente útil para la comunicación entre microservicios.
También existe una versión más económica y con menor garantía de entrega, llamada Pub/Sub Lite, pensada para cuando se prioriza el costo por encima de la máxima confiabilidad.
Managed Service para Apache Spark
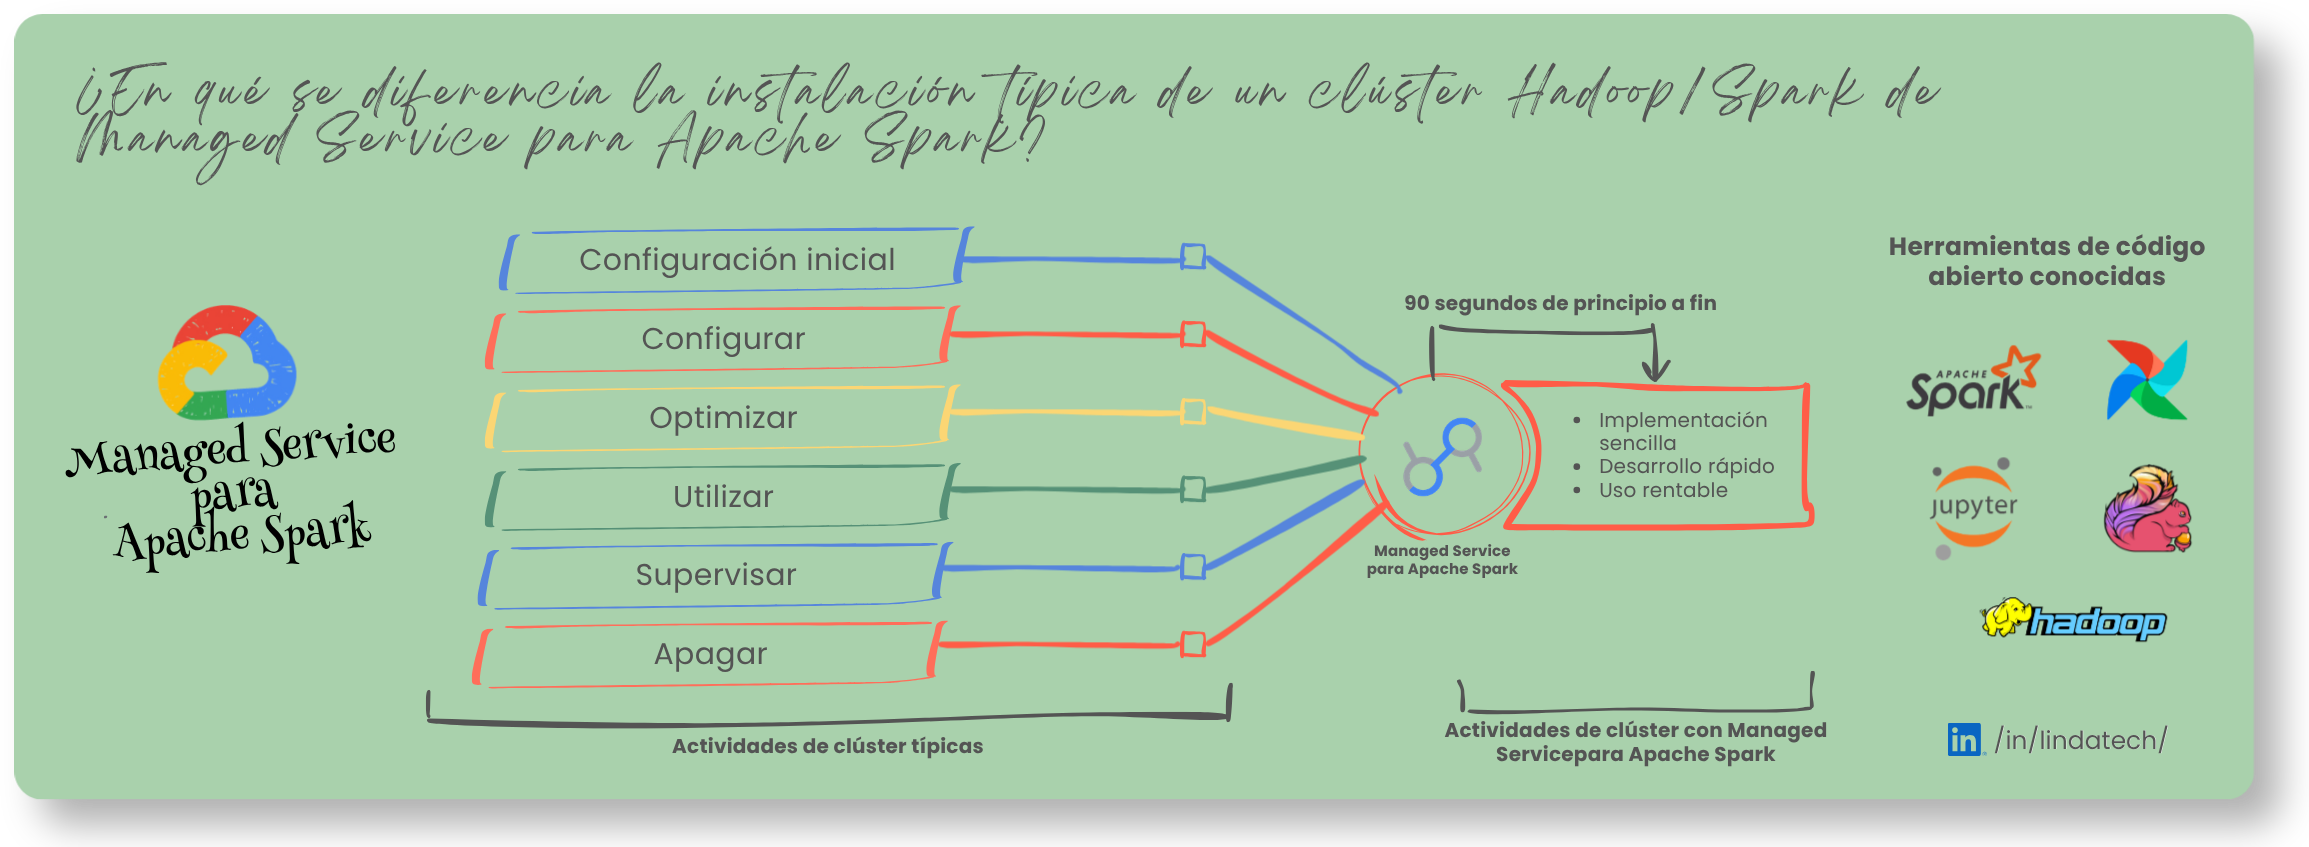
Qué es: conocido antes como Dataproc, es un servicio administrado que permite procesar grandes volúmenes de datos con herramientas de código abierto conocidas, como Apache Spark, Hadoop, Hive, Presto o Flink, sin que la empresa tenga que instalar ni mantener la infraestructura detrás.
Por qué ahorra tiempo y costo: administrar un clúster de este tipo por cuenta propia es lento, complicado y caro, hay que instalarlo, configurarlo, optimizarlo, monitorearlo y después apagarlo, mientras que aquí ese mismo clúster queda listo para usarse en unos 90 segundos. Además, los clústeres pueden ser efímeros, es decir, se crean solo mientras dura un trabajo puntual y se apagan apenas termina, en vez de dejar la infraestructura encendida todo el tiempo sin usarla, lo que ayuda a ahorrar costos. Por ejemplo, un equipo de datos que necesita procesar millones de registros para entrenar un modelo de aprendizaje automático puede crear un clúster solo para ese trabajo, y una vez que termina, el clúster desaparece y deja de generar costo.
Procesamiento y almacenamiento separados: el clúster tampoco guarda los datos en sí mismo, sino que se conecta a los servicios de almacenamiento que ya vimos, como Cloud Storage, BigQuery o Bigtable, así que el procesamiento y el almacenamiento quedan separados.
Cómo se conecta con otras herramientas: los datos que procesa se pueden explorar después con notebooks o con herramientas de inteligencia empresarial como Looker, y también quedan disponibles para equipos de ciencia de datos a través de integraciones con Vertex AI, BigQuery y Knowledge Catalog (antes Dataplex), herramientas que veremos con más detalle en próximas entradas de la serie.
Almacenamiento de datos
Una vez procesados, los datos necesitan quedarse en algún lugar, y ahí es donde entran las bases de datos, el almacén de datos y el data lake, las tres formas de almacenamiento que vamos a ver en este bloque. No todos los lugares sirven para lo mismo, y elegir mal puede significar que una aplicación responda demasiado lento, que cueste más de lo necesario, o que la información no esté disponible justo cuando se necesita.
Las bases de datos son la pieza central de esta etapa, porque sostienen el funcionamiento del día a día de cualquier aplicación, cada pedido, cada inicio de sesión, cada actualización de estado pasa primero por una base de datos antes de convertirse en algo que se pueda analizar más adelante.
Bases de datos
Una base de datos es una colección organizada de información, pensada sobre todo para sostener las operaciones del día a día de una aplicación. Por ejemplo, la base de datos donde una tienda online guarda la información de un cliente desde su primer contacto hasta que se concreta la venta, qué páginas visitó, qué agregó al carrito, cuándo hizo el pedido, para poder consultar o actualizar esos datos al instante.
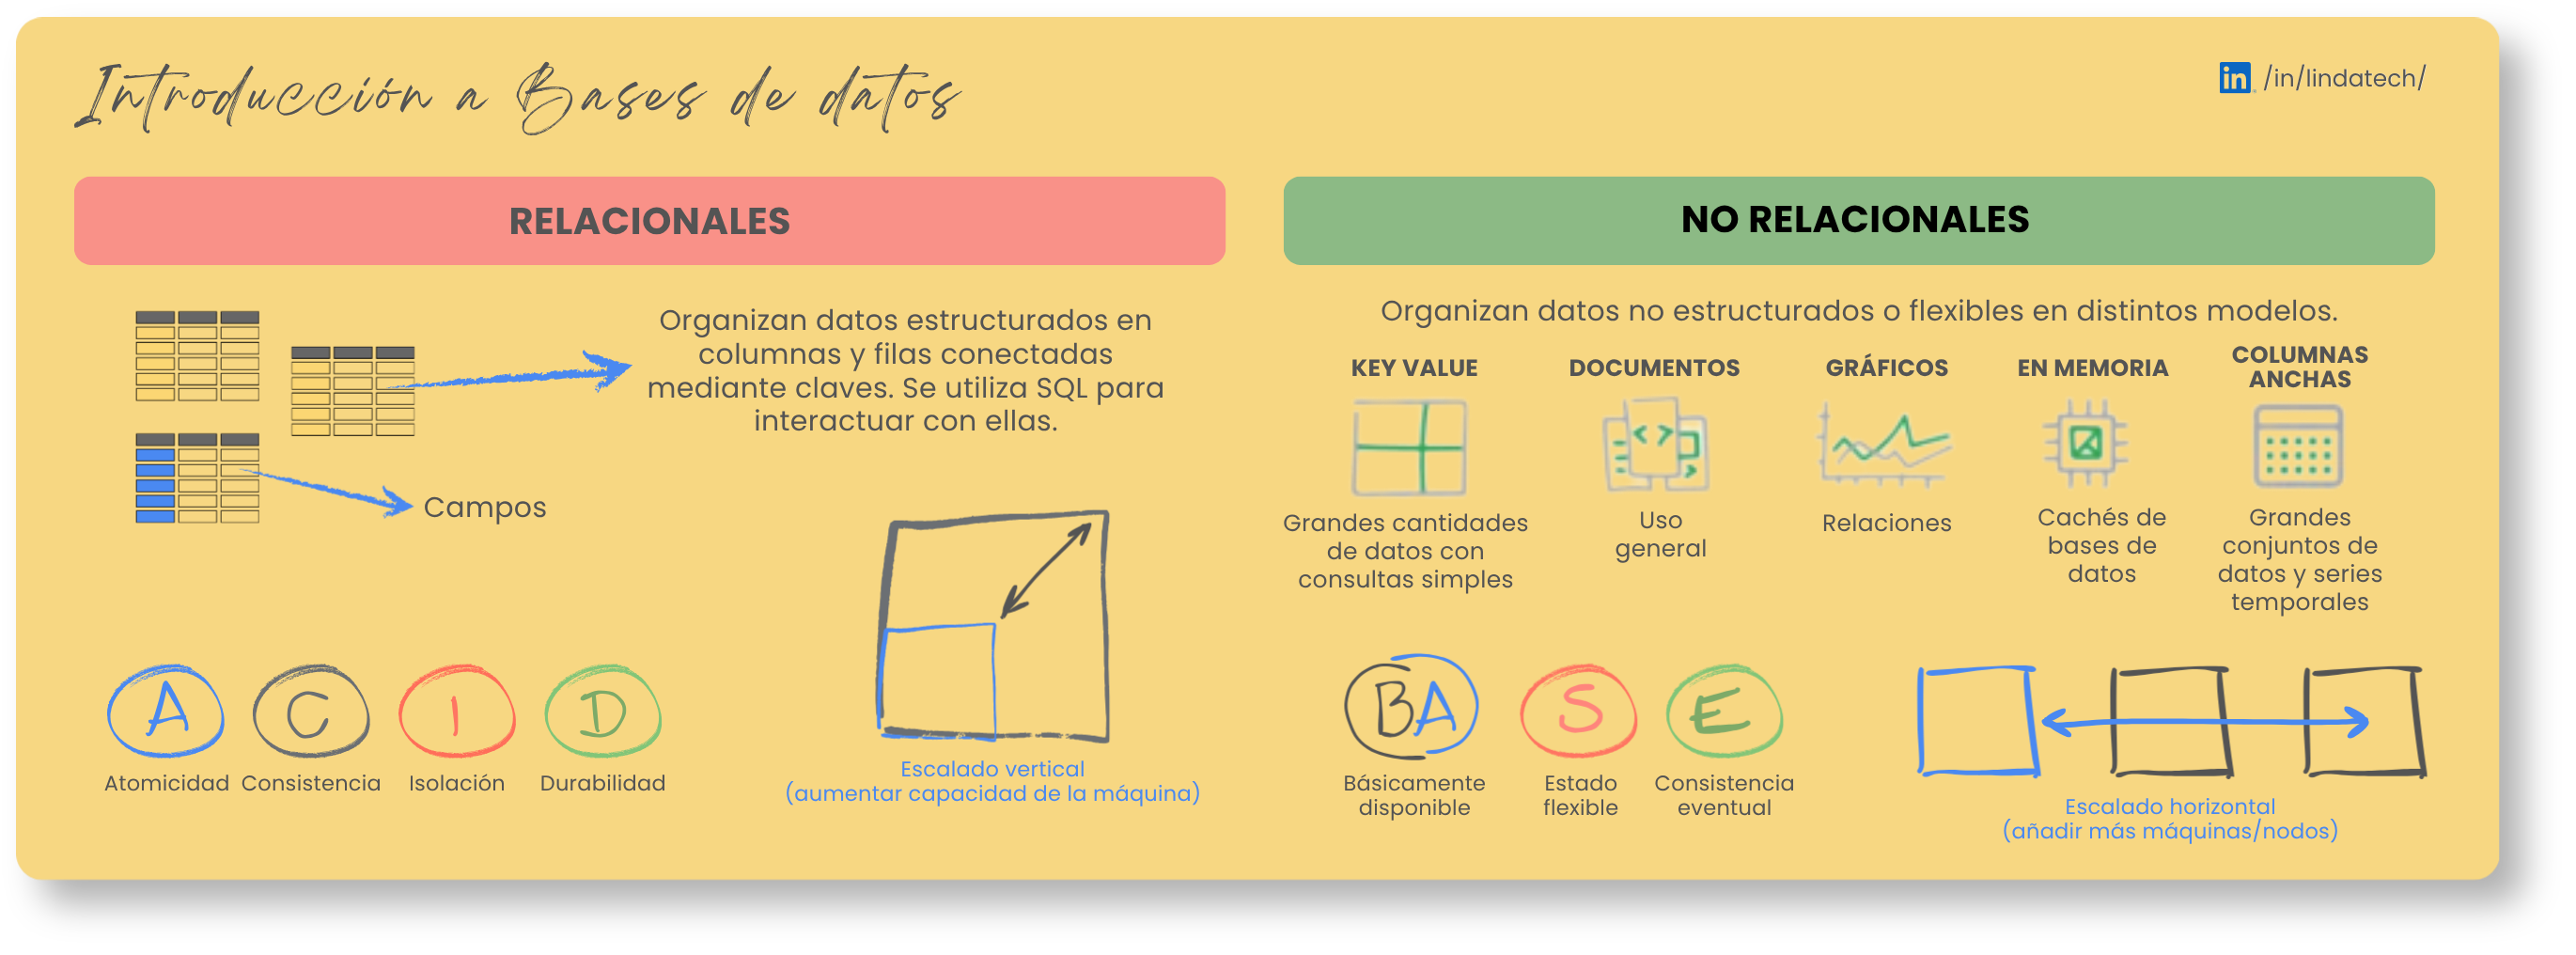
Dentro de las bases de datos hay dos grandes familias, relacionales y no relacionales, y la imagen anterior resume justo la diferencia entre ambas.
Las bases de datos relacionales, o SQL, guardan los datos en tablas con filas y columnas conectadas mediante claves, y se consultan con el lenguaje SQL, este tipo de base de datos garantizan lo que se conoce como propiedades ACID, un acrónimo que asegura que cada transacción sea confiable:
- Atómica, todos los cambios ocurren juntos o ninguno ocurre, como una transferencia bancaria, donde el dinero no puede salir de una cuenta sin entrar en la otra;
- Consistente, la base de datos queda siempre en un estado válido después de cada transacción;
- Isolation (Aislada), varias transacciones no interfieren entre sí; y es
- Duradera, los cambios quedan guardados incluso si el sistema falla justo después.
Por eso las bases de datos relacionales tradicionales, como Cloud SQL, escalan sobre todo de forma vertical, aumentando la capacidad de una misma máquina, aunque como vamos a ver, Spanner es la excepción que logra escalar horizontalmente sin sacrificar esas garantías. Entonces, ¿cuándo conviene usar cada una base de datos relacional?, pues se usa cuando:
- Los datos no cambian con mucha frecuencia.
- La precisión es fundamental.
- Hay casos de uso transaccionales, también llamados OLTP, y de propósito general.
Las bases de datos no relacionales, o NoSQL, en cambio, organizan los datos en distintos modelos según lo que se necesite guardar, pares clave valor, documentos, gráficos, en memoria o columnas anchas, y priorizan la velocidad y la flexibilidad por encima de esa garantía estricta.
Para lograr esa velocidad siguen el modelo BASE:
- están BAásicamente disponibles la mayor parte del tiempo;
- su estado puede ser Suave o flexible mientras se sincronizan los datos entre servidores; y
- su consistencia es Eventual, es decir que después de una actualización puede pasar un breve instante antes de que todos los servidores muestren el mismo dato.
Por eso escalan de forma horizontal, sumando más servidores en vez de agrandar uno solo, aunque como vamos a ver, Firestore es la excepción que sí ofrece consistencia fuerte e inmediata y transacciones con propiedades ACID, algo poco común en una base de datos no relacional. Y una base de datos no relacional funciona mejor cuando:
- Hay cambios frecuentes en los datos.
- La escala y la disponibilidad son más importantes que la precisión absoluta.
- Hay casos de uso analíticos, también llamados OLAP, y de propósito general.
Por ejemplo, una transferencia bancaria es un caso transaccional clásico y por eso usa una base de datos relacional, el dinero tiene que salir de una cuenta y entrar en la otra sin quedar nunca a medias. El feed de una red social, en cambio, recibe miles de publicaciones nuevas por segundo y necesita mostrarlas de inmediato a millones de usuarios, así que conviene una base de datos no relacional, donde importa más la escala y la velocidad que una consistencia perfecta al instante.
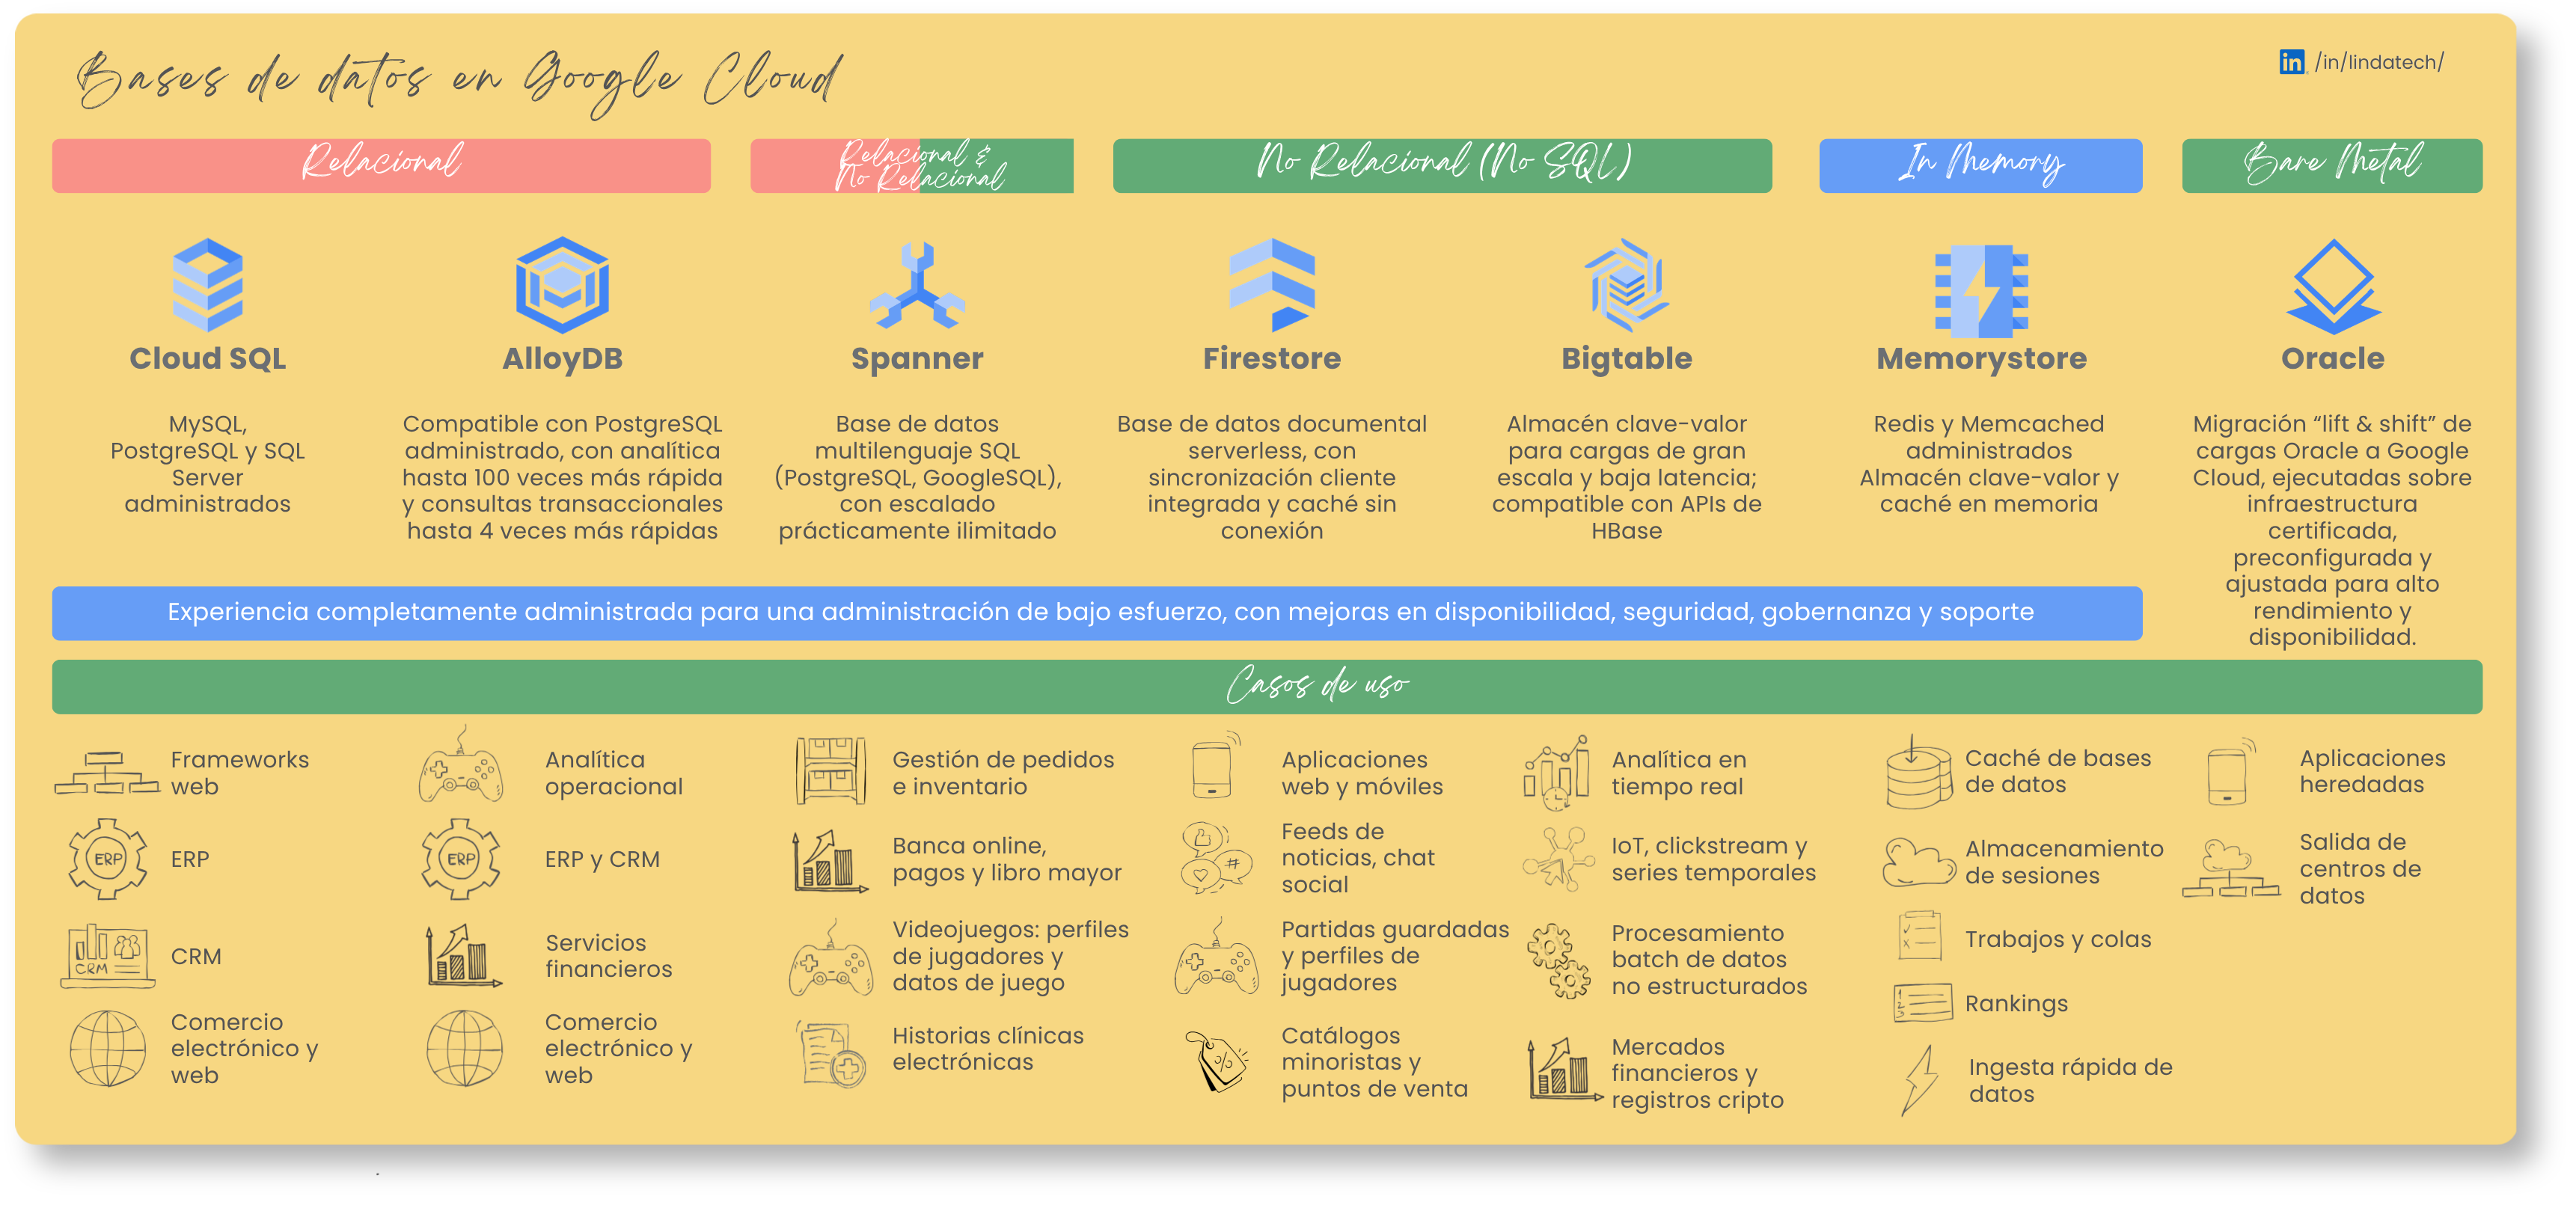
En Google Cloud, las opciones más comunes de bases de datos relacionales son:
- Cloud SQL: para aplicaciones de uso general, como un blog o una tienda online pequeña.
- AlloyDB: versión más potente y compatible con PostgreSQL, pensada para mayor rendimiento.
- Cloud Spanner: para aplicaciones que necesitan escalar a nivel mundial sin perder consistencia. En realidad combina lo relacional con lo no relacional, pero se consulta con SQL y garantiza propiedades ACID, así que la ubicamos aquí.
- Bare Metal Solution: para migrar tal cual bases de datos especializadas que ya existen, como Oracle. Es relacional por el motor que corre ahí, aunque aquí administras tú mismo la base de datos, no Google Cloud.
Y las opciones más comunes de bases de datos no relacionales son:
- Firestore: base de datos de documentos en tiempo real, para cambios que deben verse al instante.
- Cloud Bigtable: para volúmenes masivos de datos con una respuesta casi instantánea.
- Memorystore: guarda los datos en memoria para responder en microsegundos, la opción más rápida. Es no relacional, funciona como almacén de clave valor.
Cloud SQL
Es la opción más sencilla y económica cuando una aplicación no necesita nada más que una base de datos relacional tradicional, sin exigencias especiales de rendimiento o escala mundial. Google Cloud se encarga de administrar los motores más conocidos, MySQL, PostgreSQL y SQL Server, así que la empresa no tiene que preocuparse por instalar parches, hacer copias de seguridad ni configurar el motor desde cero. Por ejemplo, es la opción indicada para la base de datos de un blog, una tienda online pequeña o cualquier aplicación de uso general que no maneje un volumen enorme de usuarios simultáneos.
AlloyDB
Es una base de datos compatible con PostgreSQL, pero pensada para empresas que necesitan más rendimiento del que ofrece Cloud SQL, tanto para las operaciones del día a día como para analizar esos mismos datos sin moverlos a otra herramienta. Por ejemplo, una empresa que además de registrar sus ventas en tiempo real necesita generar reportes analíticos sobre esas mismas ventas sin esperar a un proceso de traspaso de datos hacia otro sistema. También existe una versión llamada AlloyDB Omni, pensada para quien quiere ejecutarla fuera de Google Cloud, en su propio centro de datos o en otra nube.
Cloud Spanner
Es la opción cuando una aplicación necesita escalar a nivel mundial sin perder consistencia, algo que a las bases de datos relacionales tradicionales les cuesta lograr cuando el volumen de usuarios crece mucho. Ofrece una disponibilidad de hasta el 99,999%, y combina lo relacional con lo no relacional, por eso en la imagen aparece en su propia columna, ni puramente SQL ni puramente NoSQL. Por ejemplo, un sistema de reservas de vuelos que atiende usuarios en varios continentes a la vez necesita que todos vean siempre la misma información actualizada, sin importar desde qué país se conecten.
Firestore
Es una base de datos de documentos, pensada para aplicaciones donde los cambios tienen que verse al instante en todos los dispositivos conectados, sin que nadie tenga que refrescar la pantalla. Por ejemplo, esa misma aplicación de mensajería que vimos antes, donde un mensaje nuevo aparece de inmediato para todos los participantes de la conversación, sin ningún retraso perceptible.
Cloud Bigtable
Es la opción cuando el volumen de datos es verdaderamente masivo, del orden de terabytes o petabytes, y aun así se necesita una respuesta casi instantánea. Por ejemplo, el histórico de lecturas de miles de sensores de una fábrica que envían datos todo el tiempo, o el registro de cada clic que dejan los usuarios de una aplicación con millones de personas conectadas.
Memorystore
Es la opción más rápida de todas, porque guarda los datos directamente en la memoria del servidor en vez de en disco, y responde en cuestión de microsegundos. Es compatible con Redis, Memcached y Valkey, los motores de código abierto más usados para este tipo de almacenamiento temporal. Por ejemplo, guardar el carrito de compras de los usuarios que están navegando en ese momento en una tienda online, un dato que no necesita guardarse para siempre, pero sí estar disponible al instante mientras dura la sesión.
Bare Metal Solution
Es la opción para las empresas que ya tienen bases de datos especializadas, como Oracle, y necesitan moverlas a Google Cloud tal como están, sin rediseñarlas ni adaptarlas a un nuevo motor. Google Cloud ofrece servidores físicos dedicados, certificados para ese tipo de cargas de trabajo, dentro de sus propios centros de datos, así que la empresa migra su base de datos con el mínimo de cambios posible. Por ejemplo, una empresa que lleva años operando su sistema financiero sobre Oracle y no puede permitirse reescribirlo desde cero, pero sí quiere dejar de mantener sus propios servidores físicos.
BigQuery
Un almacén de datos, o data warehouse, es un almacenamiento pensado para analizar datos estructurados y semiestructurados ya organizados, no para el día a día operativo sino para sacar reportes y estadísticas. El producto de Google Cloud para esto es BigQuery. Por ejemplo, centralizar ahí las ventas de todas las tiendas de una cadena para poder comparar el desempeño de cada una en un solo panel.
Data lake: Cloud Storage
Un data lake es un repositorio donde se guarda cualquier tipo de dato, sin necesidad de definir su estructura antes de guardarlo. El producto de Google Cloud para esto es Cloud Storage. Por ejemplo, una empresa que vuelca ahí videos, imágenes, registros de texto y archivos de todo tipo, sin decidir todavía qué va a hacer con cada uno, para después elegir cómo procesarlos según lo que necesite.
Aclaro algo que suele confundir, BigQuery guarda datos ya organizados y listos para analizar, mientras que Cloud Storage guarda los datos tal cual llegan, sin procesar, para decidir después qué hacer con ellos.
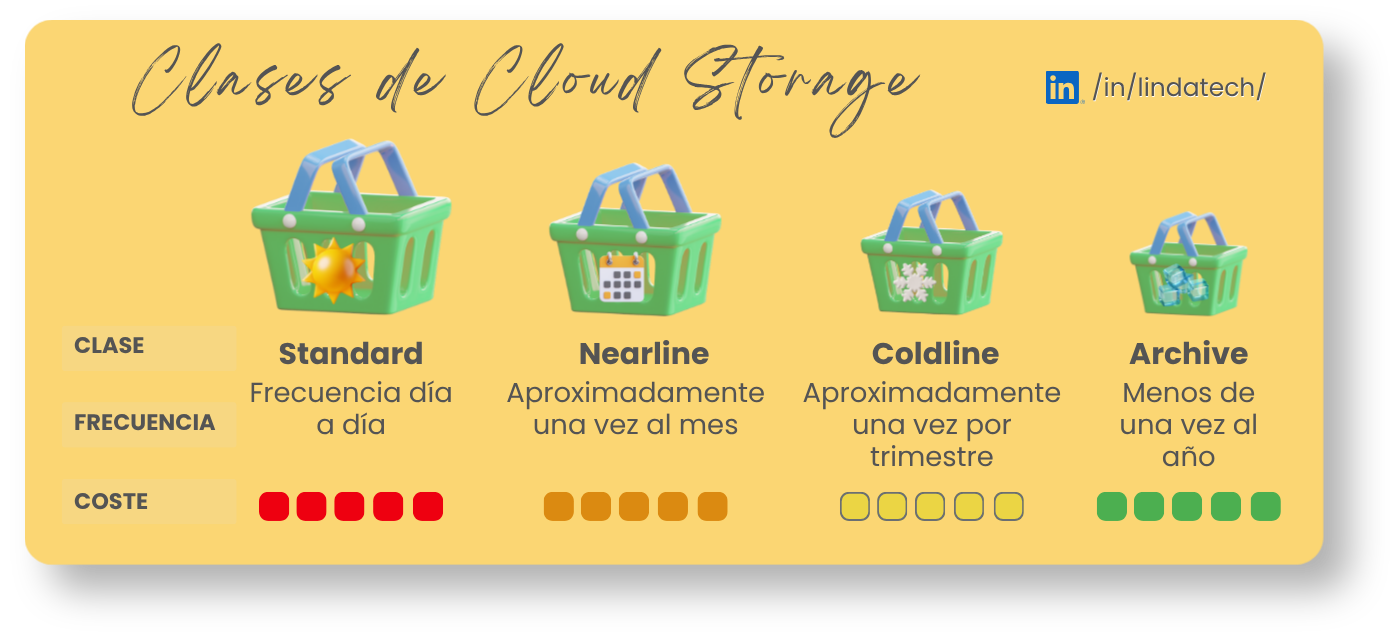
Cloud Storage además ofrece distintas clases de almacenamiento según con qué frecuencia se necesita acceder a esos datos, cada una con un costo distinto.
Por ejemplo, una empresa puede guardar en Standard los datos que su equipo consulta todos los días, en Nearline los reportes del mes pasado que revisan de vez en cuando, en Coldline información contable que solo se mira una vez por trimestre, y en Archive documentos que solo guarda por cumplimiento legal y que probablemente nunca vuelva a abrir.
Para cerrar este bloque, retomamos algo que vimos al inicio del post, los tipos de datos. La forma que tiene un dato, estructurado, semiestructurado o no estructurado, junto con el tipo de carga de trabajo, transaccional o analítica, es justo lo que determina cuál de todas estas opciones de almacenamiento conviene usar en cada caso.
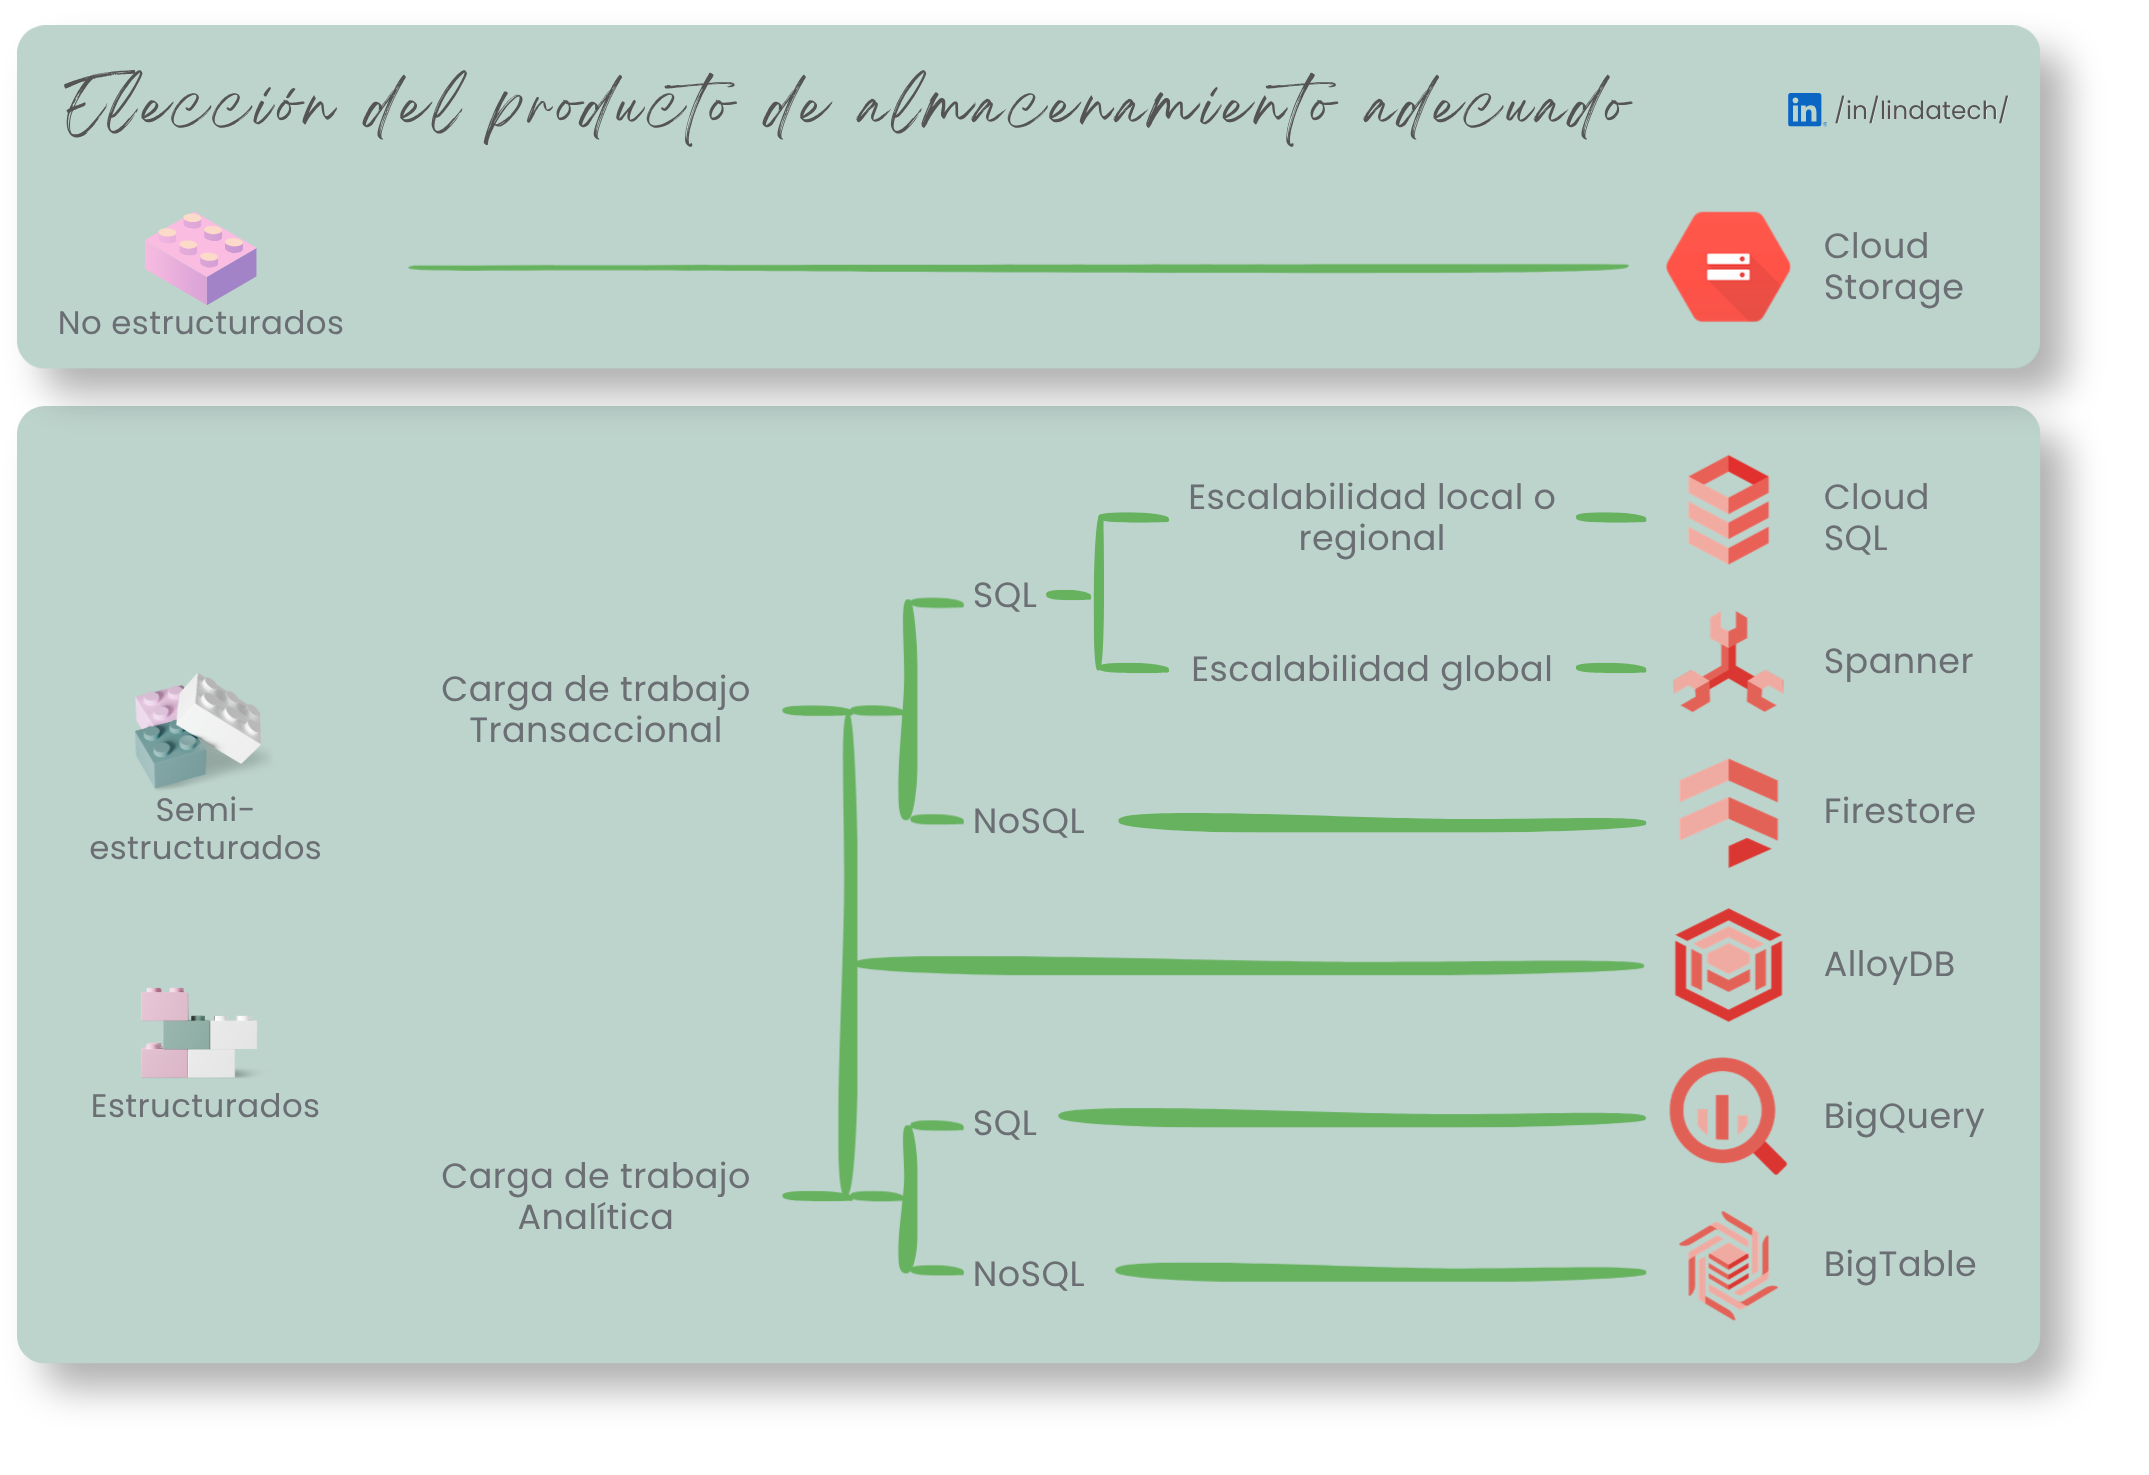
Por ejemplo, un dato no estructurado, como un video o una imagen, va directo a Cloud Storage. Un dato estructurado o semiestructurado que se actualiza todo el tiempo, como el pedido de un cliente, es una carga transaccional y necesita una base de datos, Cloud SQL o Spanner si es relacional, Firestore si es no relacional. Y ese mismo tipo de dato, pero ya consultado con fines analíticos en vez de operativos, apunta hacia BigQuery o Bigtable.
Análisis y activación
La última etapa es la que le da sentido a todo lo anterior, convertir los datos ya procesados en información que realmente ayude a tomar decisiones.
- Looker: plataforma de inteligencia empresarial de Google, basada al cien por cien en la web, que permite explorar los datos y construir paneles de control. Por ejemplo, un gerente que revisa desde el navegador, sin instalar nada, un panel actualizado con las ventas del día de todas las tiendas de la empresa.
- Análisis de transmisiones (streaming analytics): procesamiento de datos en tiempo real para poder reaccionar de inmediato, en vez de esperar a analizarlos después. El infograma muestra tres ejemplos de a qué industrias aplica:
- Comercio electrónico: ajusta precios, compras e inventario en tiempo real. Por ejemplo, una tienda online que sube el stock disponible de un producto en el momento en que detecta que se está por agotar.
- Servicios financieros: detecta comportamientos anómalos y genera alertas al instante. Por ejemplo, un banco que bloquea automáticamente una tarjeta apenas detecta un cargo que no encaja con el patrón de consumo habitual del cliente.
- Medios de comunicación: recomienda contenido personalizado combinando datos demográficos. Por ejemplo, una plataforma de streaming que sugiere una serie distinta a cada usuario según su edad, ubicación e historial de reproducción.
Términos y definiciones
Te presento el glosario de esta entrada, con los términos que acabamos de ver explicados de forma sencilla:
Pipeline o canalización de datos
Es el recorrido automatizado que sigue un dato desde que se genera hasta que llega procesado a su destino final, pasando por distintas etapas de transformación en el camino. Por ejemplo, es como una cinta transportadora en una fábrica, el producto entra por un lado, pasa por varias estaciones donde se le hace algo distinto en cada una, y sale terminado por el otro extremo.
Serverless
Es un modelo en el que el proveedor de la nube administra toda la infraestructura por detrás, servidores, capacidad y mantenimiento incluidos, y quien usa el servicio no tiene que preocuparse por nada de eso, solo por el resultado. Por ejemplo, es como pedir comida a domicilio, tú solo eliges qué quieres comer, sin tener que comprar los ingredientes, cocinar ni lavar los platos después.
Evento
Es cualquier suceso que ocurre dentro de un sistema y que puede disparar una acción en otro, por ejemplo un clic, un pago o un cambio de estado. Por ejemplo, es como una alarma que suena apenas pasa algo puntual, alguien más la escucha y reacciona de inmediato, sin tener que estar revisando constantemente si pasó algo.
ETL
Son las siglas en inglés de extraer, transformar y cargar, el proceso de tomar datos de su origen, limpiarlos o adaptarlos, y llevarlos hasta el lugar donde se van a almacenar o analizar. Por ejemplo, es como mudarte de casa, primero sacas tus cosas del lugar donde estaban, eso es extraer, las organizas y empacas de otra forma, eso es transformar, y las colocas en su lugar definitivo en la casa nueva, eso es cargar.
Metadatos
Son datos que describen a otros datos, sin ser el contenido en sí mismo, por ejemplo la fecha, el autor o el tamaño de un archivo. Por ejemplo, es como la ficha técnica pegada en la contraportada de un libro, no es la historia del libro, pero te dice datos clave sobre él, como el autor, el año y el número de páginas.
Microservicios
Es una forma de construir aplicaciones dividiéndolas en piezas pequeñas e independientes, cada una encargada de una sola función, que se comunican entre sí en vez de ser todo un único bloque de código. Por ejemplo, es como un restaurante donde cada persona se encarga de una sola tarea, uno cocina, otro sirve las mesas y otro cobra, en vez de que una sola persona haga todo, así si uno falla o hay que reemplazarlo, no se detiene todo el restaurante.
SLA
Son las siglas en inglés de Service Level Agreement, o acuerdo de nivel de servicio, el compromiso que asume un proveedor sobre la disponibilidad o el rendimiento garantizado de un servicio, normalmente expresado como un porcentaje. Por ejemplo, un SLA del 99,999%, como el de Spanner, significa que el servicio puede estar caído apenas unos minutos al año, así que cuanto más cerca esté ese número del 100%, menos tiempo de interrupción hay que tolerar.
Carga de trabajo transaccional
Es el tipo de uso donde el sistema registra y actualiza datos constantemente, en operaciones individuales, cortas y frecuentes, también conocido como OLTP, procesamiento de transacciones en línea. Por ejemplo, cada vez que un cliente hace un pedido, inicia sesión o actualiza su carrito de compras, se genera una transacción nueva que la base de datos tiene que guardar de inmediato.
Carga de trabajo analítica
Es el tipo de uso donde el sistema consulta grandes volúmenes de datos ya almacenados para encontrar patrones o generar reportes, también conocido como OLAP, procesamiento analítico en línea. Por ejemplo, revisar las ventas de los últimos doce meses para decidir en qué región abrir una nueva tienda no necesita una respuesta instantánea, pero sí tiene que analizar muchísima información a la vez.
Con esto ya tienes cubierto el segundo pilar de la certificación, desde el origen de los datos hasta cómo se activan en decisiones. En la próxima entrada de la serie voy a meterme con el tercer pilar, la inteligencia artificial. ¿Cuál de estas etapas del recorrido del dato te resulta más familiar en tu día a día?
← Entrada anterior
Transformación digital con Google Cloud
Siguiente entrada →
Innova con la IA de Google Cloud