En la primera entrada de esta serie vimos el mapa completo de la certificación Cloud Digital Leader y un recorrido breve por sus seis pilares. Toca ahora profundizar en el primero de ellos, la transformación digital, con las definiciones y ejemplos de cada uno de ellos.
Como ya vimos, la transformación digital es usar tecnologías modernas, como las plataformas en la nube, para crear o modificar los procesos, la cultura y la experiencia de cliente de una empresa.
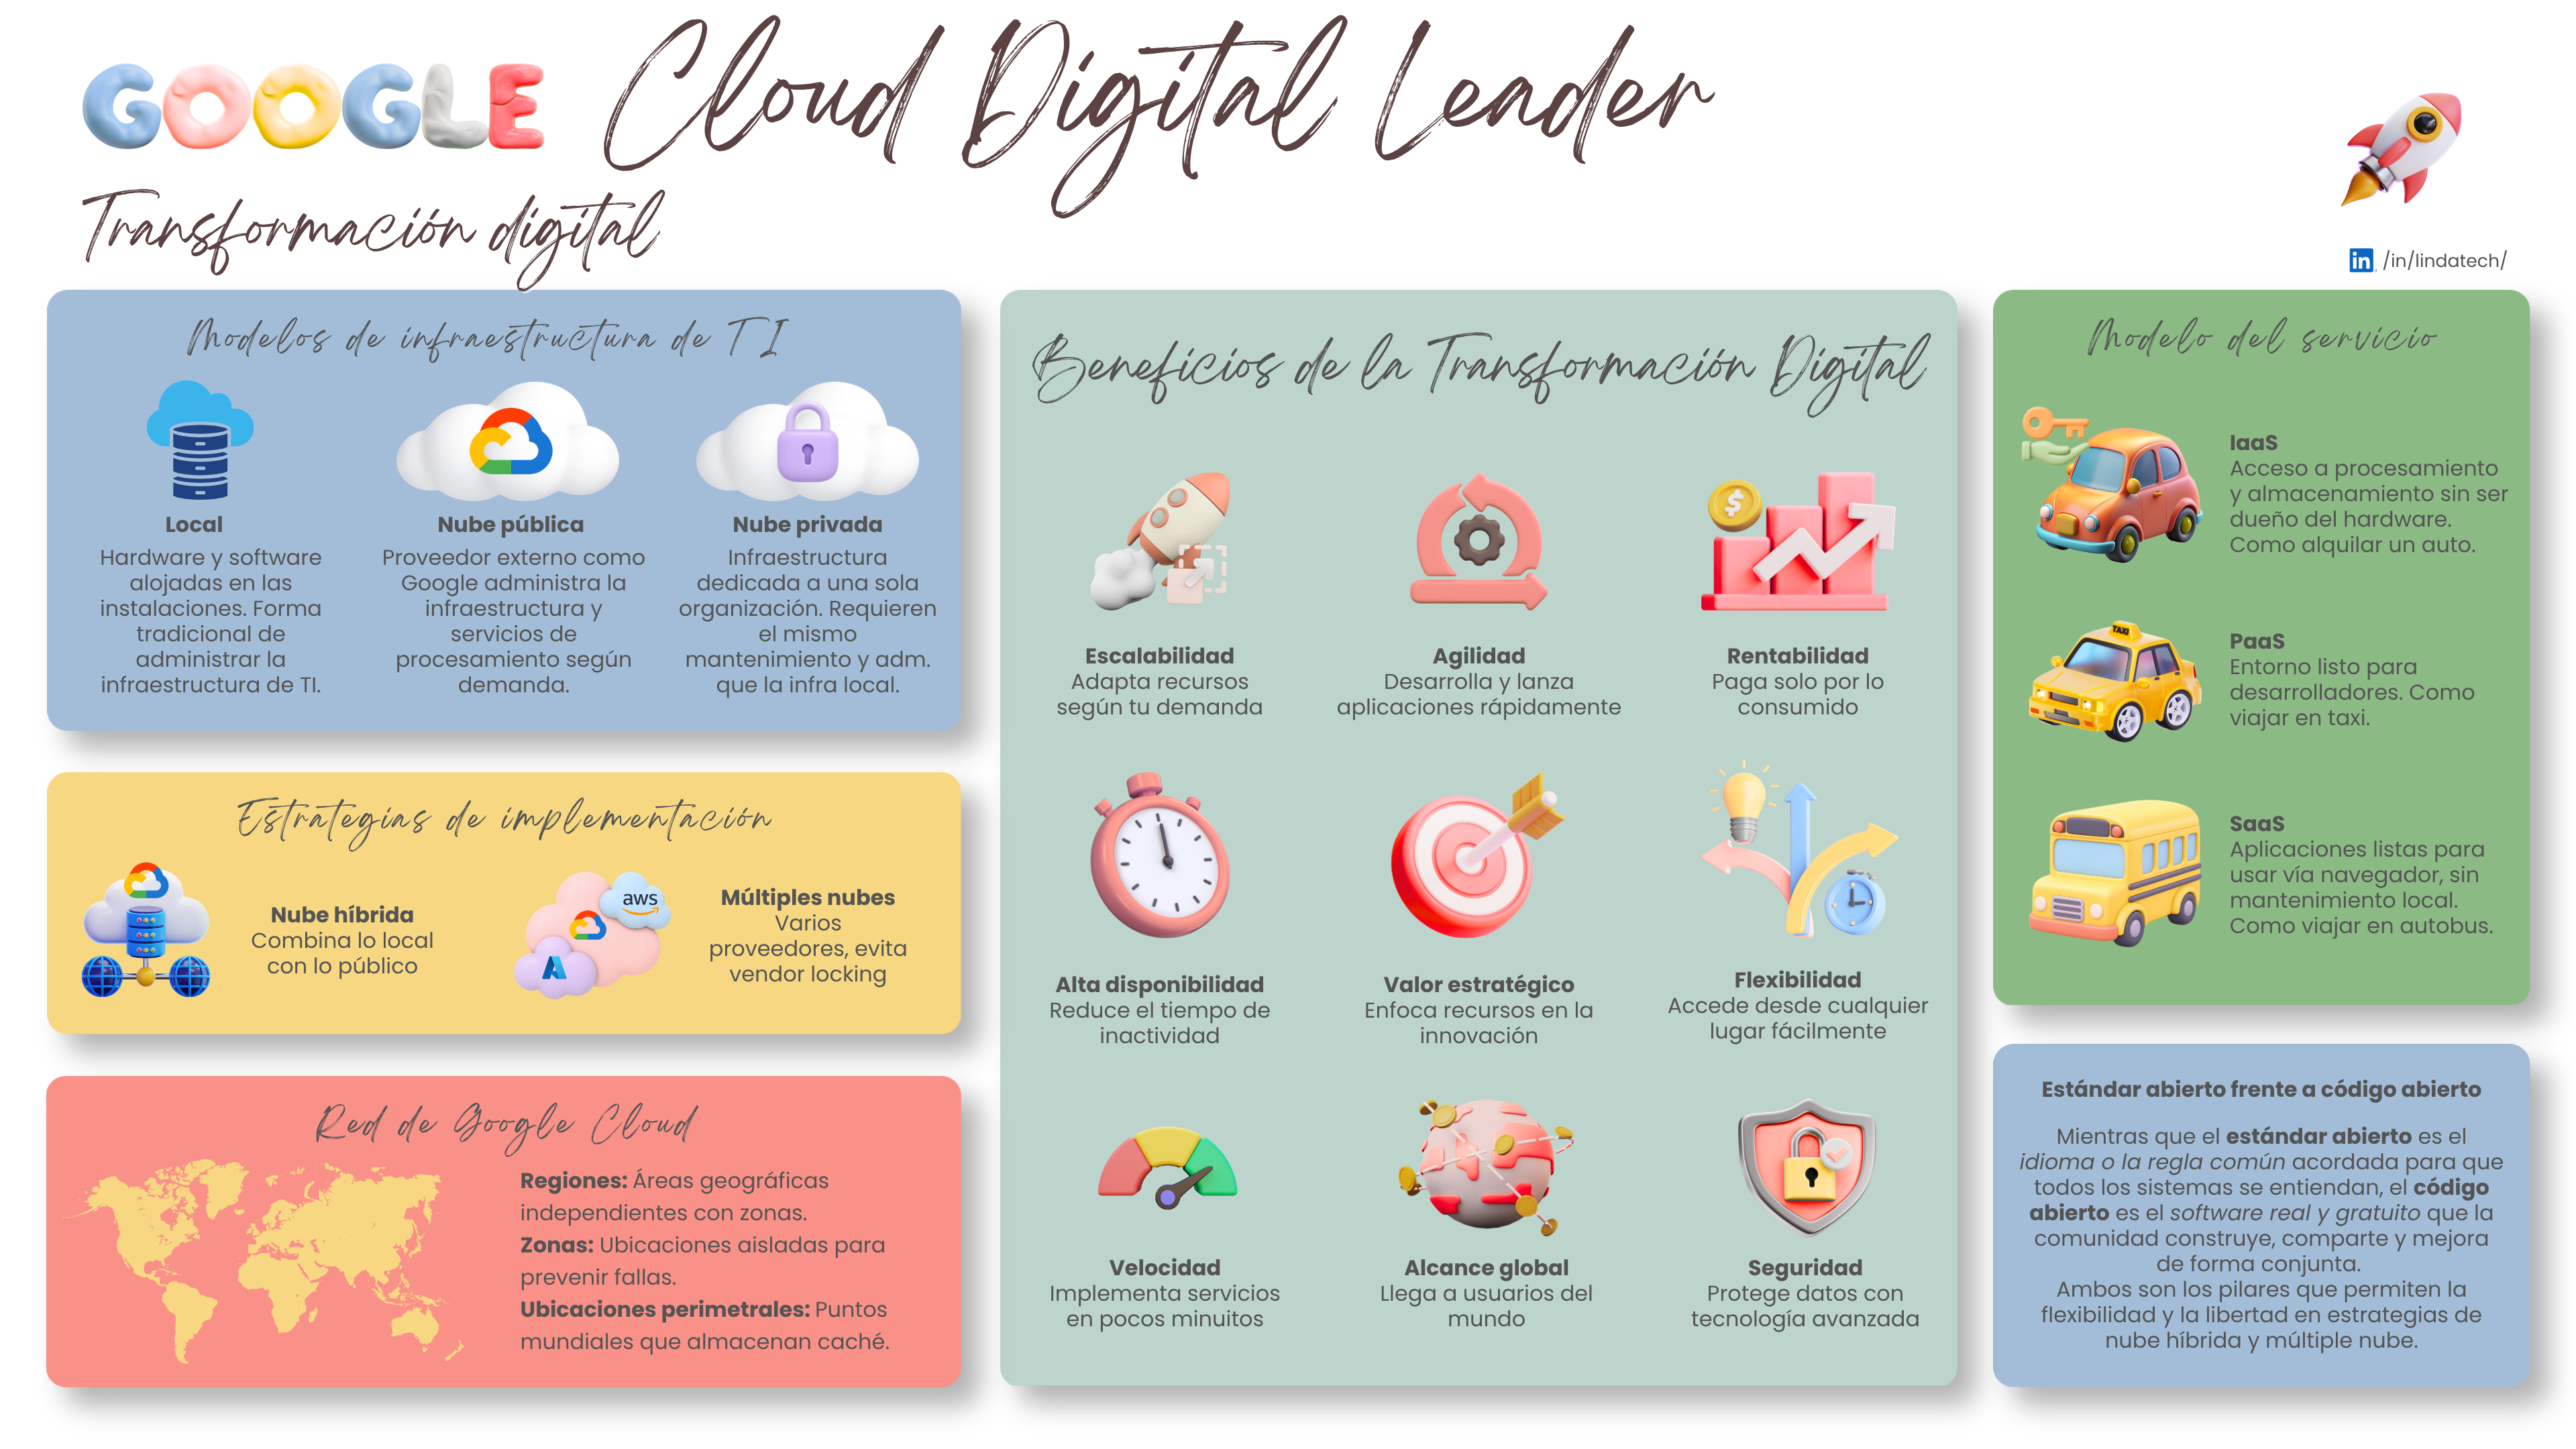
En esta entrada vamos a ver qué modelos de infraestructura existen, las estrategias de implementación en la nube, cómo funciona la red de Google Cloud, qué beneficios concretos trae este cambio, las diferencias entre estándar abierto y código abierto y cómo se organizan los distintos modelos de servicio en la nube.
Beneficios de la transformación digital
Google Cloud resume en diez puntos los beneficios que persigue una empresa cuando se transforma digitalmente. Para que se note la diferencia, en cada uno contrasto qué pasa en la nube frente a lo que pasaría con infraestructura local, la tradicional que vimos en el bloque anterior:
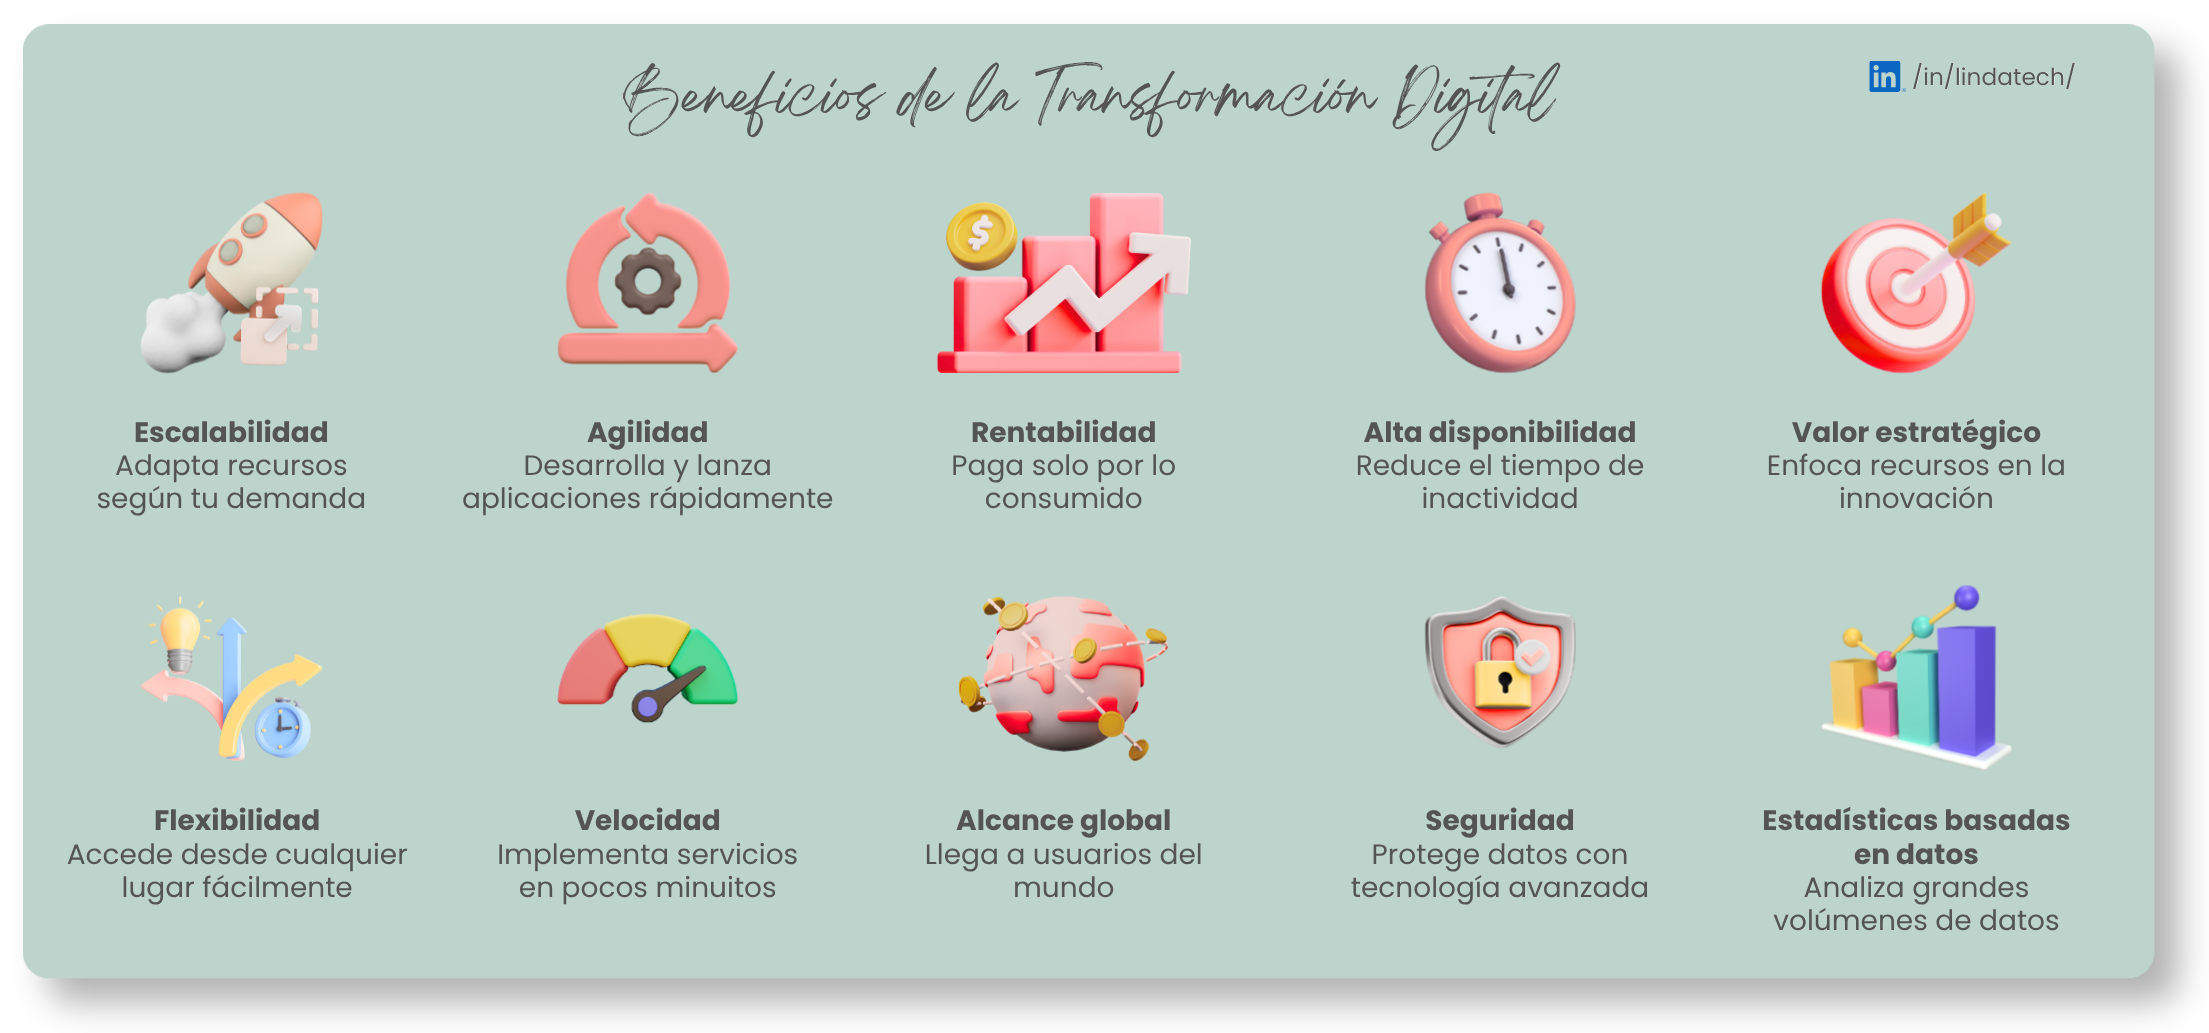
Escalabilidad
Adapta los recursos según la demanda del momento. Una tienda online que espera un pico de ventas en Navidad puede escalar sus servidores en la nube solo esos días y volver a la normalidad después, mientras que con infraestructura local habría tenido que comprar con meses de antelación servidores que se quedan sin usar el resto del año.
Agilidad
Permite desarrollar y lanzar aplicaciones más rápido que con infraestructura tradicional. Un equipo puede crear un entorno de pruebas en la nube en minutos, mientras que en un centro de datos propio tendría que esperar semanas a que TI aprovisione un servidor físico nuevo.
Rentabilidad
Paga solo por lo que consumes. Una empresa que lanza una aplicación nueva paga en la nube solo por el procesamiento que usan sus primeros usuarios, mientras que con infraestructura local habría tenido que comprar servidores calculando una demanda futura que todavía no conoce.
Alta disponibilidad
Los servicios siguen funcionando incluso si falla algún componente puntual. Si un disco falla en la nube, el sistema redirige el tráfico a otro sin que el cliente lo note, mientras que en un servidor local esa misma falla puede significar horas de caída hasta que alguien del equipo de TI la repare físicamente.
Valor estratégico
Libera tiempo y presupuesto que antes se iban en mantener infraestructura. El equipo de TI que antes pasaba días actualizando servidores físicos puede dedicar ese tiempo a construir el producto que sí ven los clientes, en vez de quedarse en tareas de mantenimiento invisibles para el negocio.
Flexibilidad
Permite elegir, cambiar y combinar servicios según lo que necesite cada proyecto. Un equipo puede probar una base de datos distinta para un proyecto nuevo sin comprometerse a largo plazo, mientras que con infraestructura local cambiar de tecnología implica comprar y configurar hardware nuevo.
Velocidad
Pone servicios nuevos en marcha en cuestión de minutos, no de semanas. Activar un servidor en la nube toma minutos desde una consola, mientras que en infraestructura local implica pedir el hardware, esperar a que llegue e instalarlo físicamente.
Alcance global
Permite llegar a usuarios de cualquier parte del mundo apoyándote en la infraestructura ya construida por el proveedor. Una empresa pequeña puede lanzar su aplicación para usuarios en varios países usando las regiones de Google Cloud, algo que con infraestructura local exigiría construir o alquilar centros de datos propios en cada país.
Seguridad
Protege los datos con tecnología que sería difícil de igualar dentro de una infraestructura propia. En la nube, los datos quedan cifrados y monitoreados por equipos de seguridad dedicados de Google, mientras que en infraestructura local esa misma protección depende del presupuesto y del equipo de seguridad que tenga cada empresa.
Estadísticas basadas en datos
Al concentrar el procesamiento y el almacenamiento en la nube, es mucho más sencillo analizar grandes volúmenes de datos y sacar estadísticas casi al instante para tomar decisiones. Una tienda online puede ver en un panel actualizado en tiempo real cuántas visitas y ventas tiene por país, mientras que con infraestructura local montar ese mismo análisis exigiría comprar servidores adicionales solo para procesar los datos, además del tiempo de configurarlos.
Modelos de infraestructura de TI
Cuando hablamos de nube conviene ubicar las distintas formas en que una organización puede alojar su infraestructura de TI, porque la transformación digital no siempre significa lo mismo para todas las empresas.
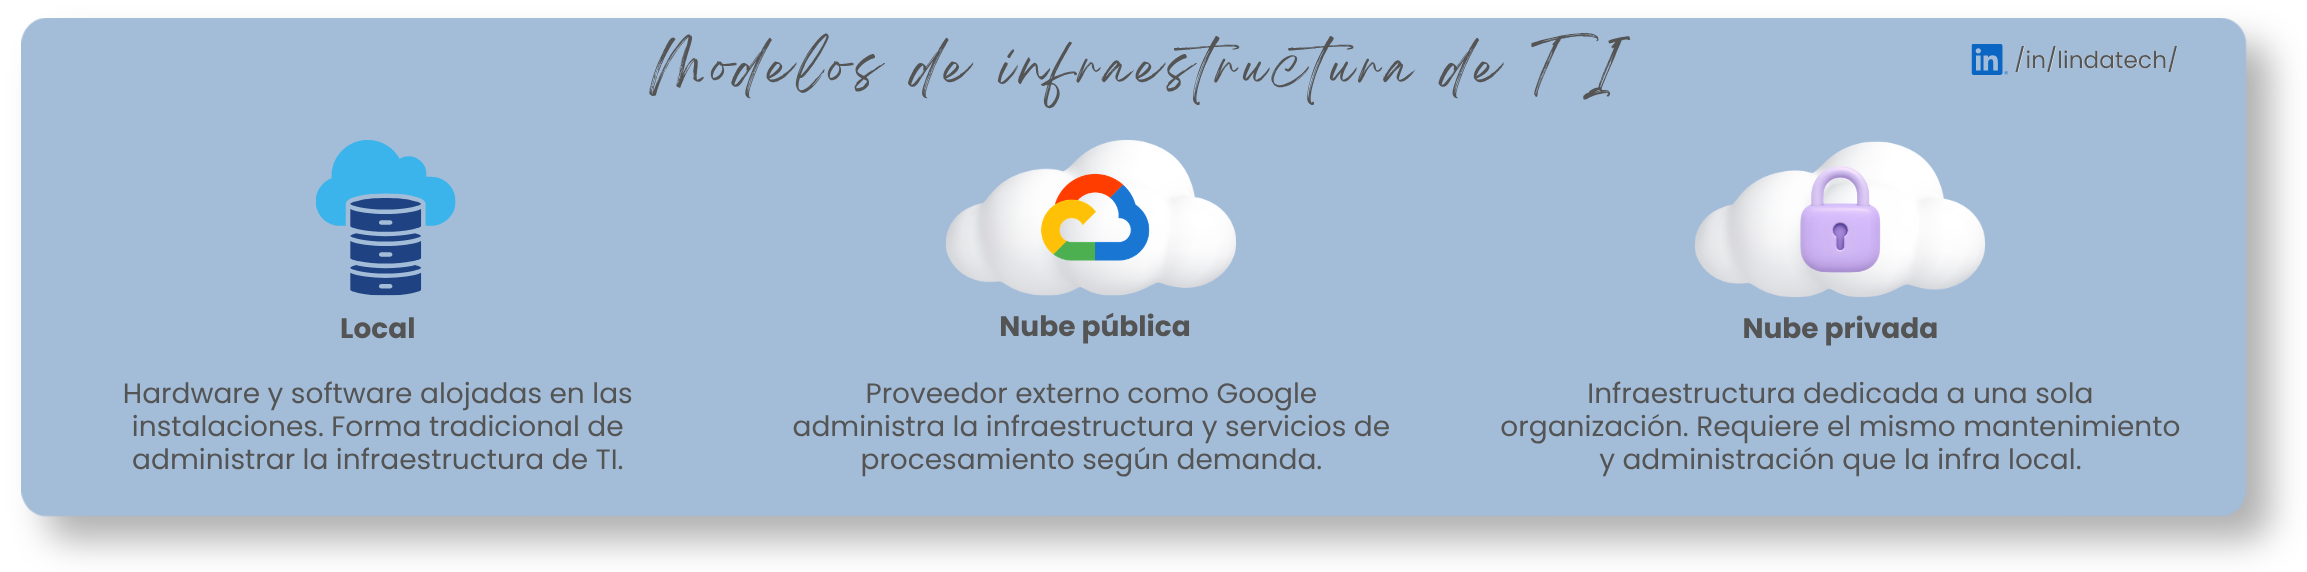
La infraestructura local, o on premise, es la forma tradicional. El hardware y el software están alojados en las propias instalaciones de la empresa, que se encarga de comprarlo, mantenerlo y actualizarlo. Por ejemplo, una clínica pequeña que tiene su propio servidor físico en una sala del consultorio, donde corre el sistema de historias clínicas, y es el personal de TI de la propia clínica quien lo instala, actualiza y repara.
La nube pública funciona distinto porque un proveedor externo, como Google, administra la infraestructura y entrega procesamiento y almacenamiento según la demanda de cada cliente, sin que la empresa tenga que poseer ni operar el hardware. Por ejemplo, una startup que aloja toda su aplicación en Google Cloud, usando los mismos centros de datos que miles de otras empresas, y paga solo por el procesamiento y almacenamiento que realmente consume, sin ser dueña de ningún servidor.
La nube privada es un punto intermedio, ya que es infraestructura dedicada a una sola organización, pero esa organización sigue necesitando el mismo mantenimiento y la misma administración que tendría con infraestructura local. Por ejemplo, un banco que necesita que su infraestructura no se comparta con nadie más por temas regulatorios, así que tiene servidores dedicados solo a él, ya sea en su propio centro de datos o en uno de un proveedor, pero su propio equipo de TI sigue encargándose de mantenerlos y actualizarlos, igual que si fuera infraestructura local.
Estrategias de implementación
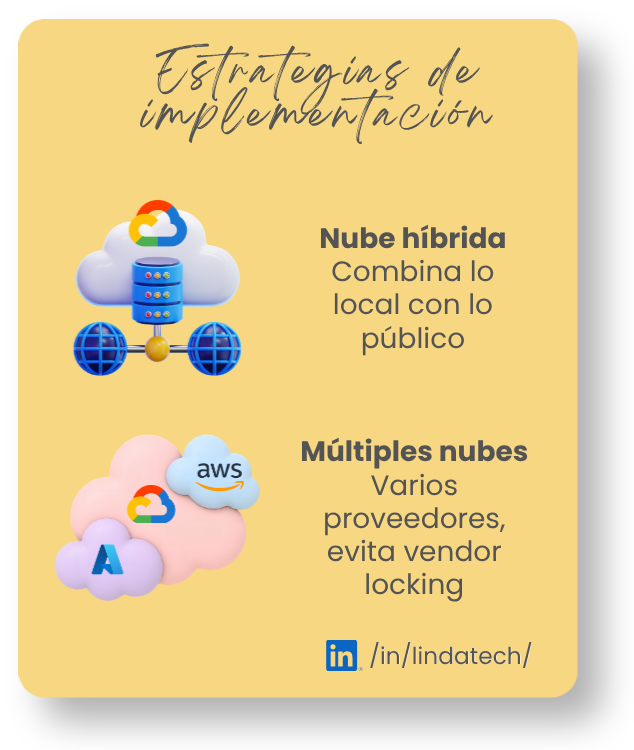
Una vez que una empresa decide dar el salto a la nube, todavía tiene que elegir cómo combinarla con lo que ya tiene.
La nube híbrida combina infraestructura local con infraestructura pública, algo habitual en empresas que no pueden o no quieren mover el cien por ciento de sus sistemas a la nube de inmediato, quizás porque tienen aplicaciones antiguas difíciles de migrar o porque algún dato debe quedarse en sus propias instalaciones por regulación. Por ejemplo, un hospital que mantiene las historias clínicas de los pacientes en sus propios servidores, dentro de sus instalaciones, porque una normativa de protección de datos de salud le exige que esa información no salga de ahí, pero al mismo tiempo aloja su web de citas online y sus paneles de estadísticas en Google Cloud, conectando ambos entornos entre sí.
La estrategia de múltiples nubes, en cambio, consiste en trabajar con varios proveedores de nube a la vez, la razón principal para elegirla es evitar el vendor locking, es decir, evitar quedar atada a un solo proveedor y perder margen de negociación o flexibilidad técnica. Por ejemplo, estuve en una empresa que alojaba en Azure su CRM y todos los datos de pedidos y ventas, mientras que sus datos de marketing, en concreto los de GA4, los alojaba en Google Cloud, porque Google ofrece la transferencia directa de esos datos desde GA4 a BigQuery. Ahí la empresa terminaba usando dos nubes distintas, cada una para el tipo de dato que mejor encajaba con ese proveedor.
La red global de Google Cloud
La transformación digital también depende de la infraestructura de red que sostiene todo lo anterior, así que vale la pena tener claros tres términos.
Las regiones son áreas geográficas independientes, compuestas a su vez por zonas. Las zonas son ubicaciones aisladas entre sí, pensadas para prevenir que una falla en un lugar afecte a los demás. Las ubicaciones perimetrales son puntos alrededor del mundo que almacenan contenido en caché para que llegue más rápido a los usuarios finales, sin importar en qué región esté alojada la aplicación.
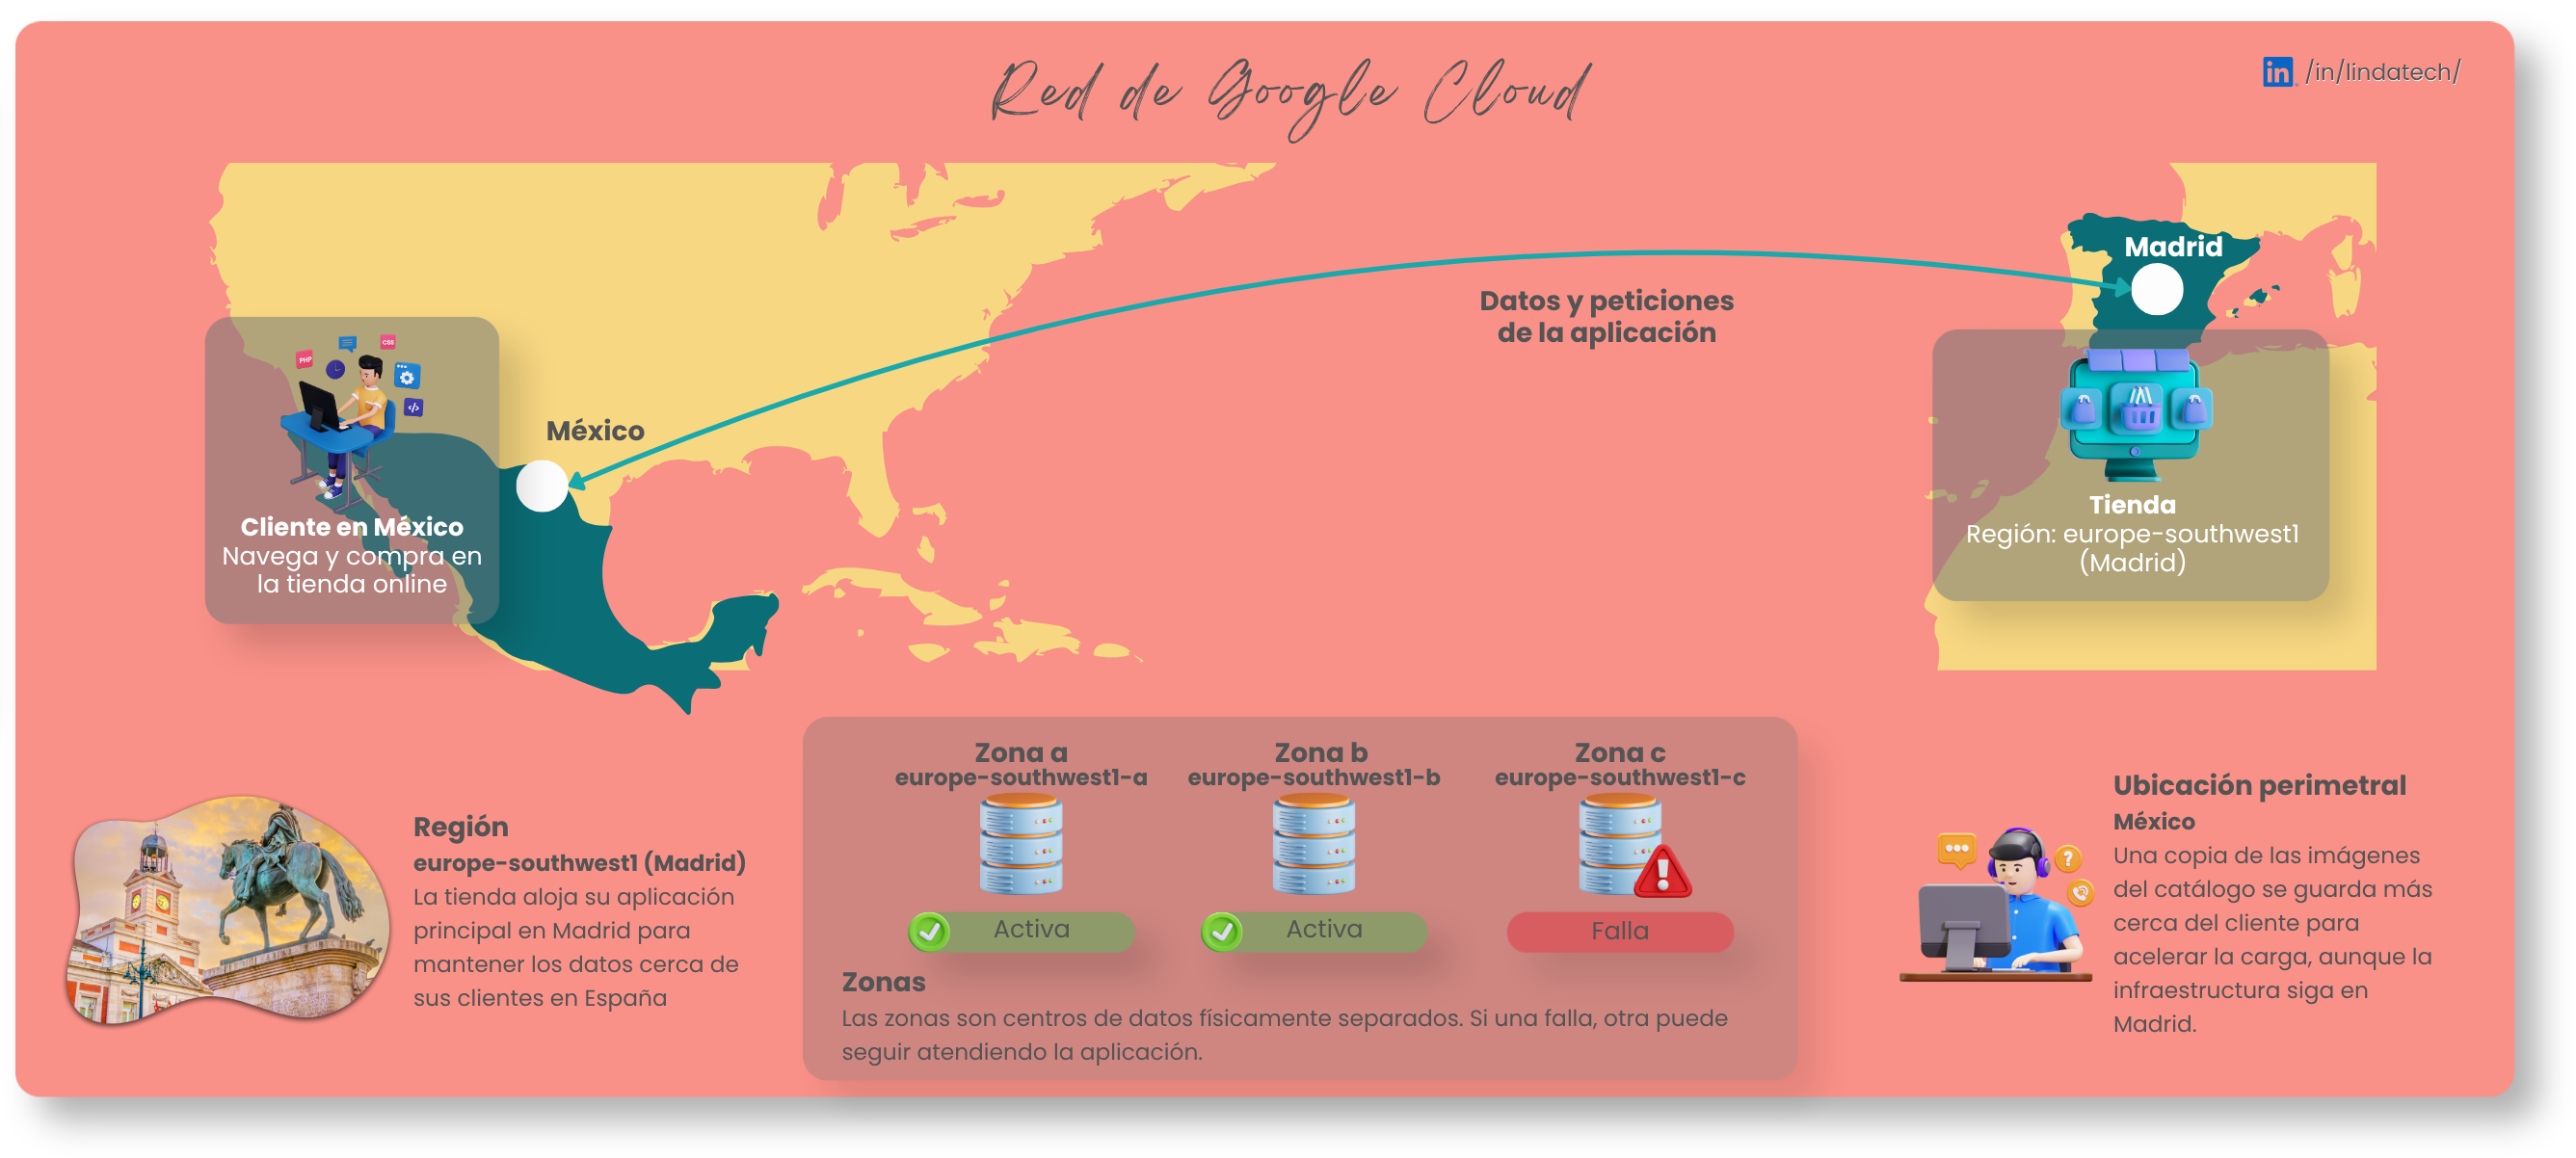
Para ver la diferencia entre las tres con un solo caso, imagina una tienda online española que decide alojar su aplicación en la región de Madrid, europe southwest1, porque la mayoría de sus clientes están en España y prefiere tener sus datos cerca. Dentro de esa misma región, Google ofrece varias zonas, por ejemplo europe southwest1 a, b y c, que son en la práctica distintos centros de datos físicamente separados entre sí. Si la tienda distribuye su base de datos entre dos de esas zonas y una sufre un corte eléctrico o un fallo de hardware, la aplicación sigue funcionando desde la otra zona sin que el cliente note nada raro. Ahora imagina que alguien entra a esa misma tienda desde México, en vez de que cada imagen del catálogo viaje desde Madrid hasta México cada vez que alguien la carga, una copia de esas imágenes queda guardada en una ubicación perimetral más cercana a ese cliente, así que la página le carga más rápido aunque toda la infraestructura principal siga estando en Madrid.
Modelos de servicio
Estos tres modelos definen cuánto administra la empresa y cuánto administra el proveedor de la nube. Uso la misma analogía que se detalla en la ruta de Google Skills porque es la que mejor lo explica.
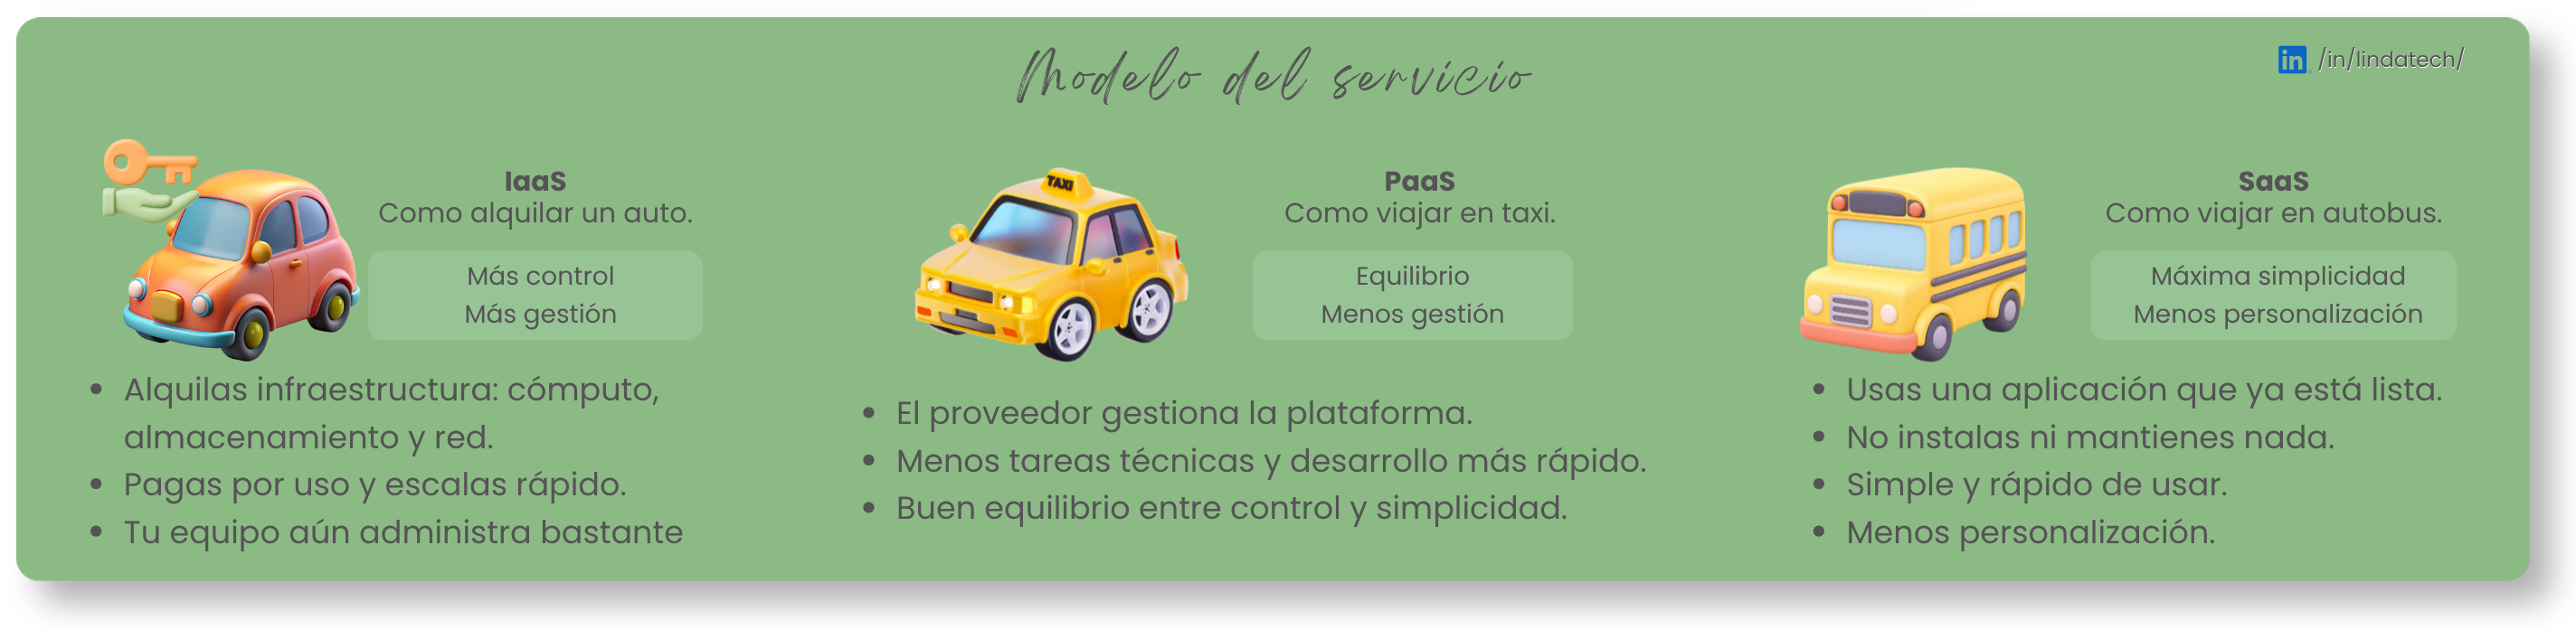
- IaaS, infraestructura como servicio, da acceso a procesamiento y almacenamiento sin que la empresa sea dueña del hardware, algo parecido a alquilar un auto, porque tú decides cómo lo usas, pero no tienes que preocuparte por fabricarlo ni por su mantenimiento de fábrica.
- PaaS, plataforma como servicio, entrega un entorno ya listo para que un equipo de desarrollo trabaje, sin tener que configurar la infraestructura de por debajo, algo parecido a viajar en taxi, porque alguien más conduce y se ocupa del vehículo mientras tú solo indicas a dónde quieres llegar.
- SaaS, software como servicio, son aplicaciones listas para usar desde el navegador, sin ningún mantenimiento local, algo parecido a viajar en autobús, porque solo subes, disfrutas el trayecto y no tienes que pensar en el vehículo en ningún momento.
Estándar abierto vs código abierto
Son dos conceptos que se confunden con facilidad y que además son la base de las estrategias de nube híbrida y múltiples nubes que vimos antes. Una anécdota personal es que no identifiqué inmediatamente a qué se refería con “código abierto”, pero es el famoso “open source”, personalmente estaba familiarizada más con el término “open source”, lo menciono porque podría sucederles lo mismo.
El estándar abierto es el idioma o la regla común que se acuerda para que todos los sistemas puedan entenderse entre sí. El código abierto es el software real y gratuito que una comunidad construye, comparte y mejora de forma conjunta.
Aquí conviene aclarar algo que también me generó dudas al estudiar esto, y es que Google Cloud, como plataforma, no es de código abierto, es un servicio propietario de Google. Lo que sí hace Google es apoyarse fuertemente en estándares abiertos y en proyectos de código abierto, y en varios casos los ha creado. El ejemplo más claro es Kubernetes, un proyecto de código abierto que nació dentro de Google y que hoy es el estándar de facto para administrar contenedores en cualquier nube. Sobre esa misma base, Google construyó Anthos, su plataforma para administrar cargas de trabajo tanto en Google Cloud como en infraestructura local, en AWS o en Azure, precisamente porque Kubernetes es un estándar abierto que cualquier proveedor puede usar.
Ahí está el hilo con todo lo que vimos en este bloque. Esto entra en el examen porque el estándar abierto y el código abierto son la base técnica que hace posible moverte entre nubes, sin depender de que Google, ni ningún otro proveedor, sea de código abierto. Ambos son los que permiten la flexibilidad y la libertad de las que hablamos antes.
Términos y definiciones
Te presento el glosario de esta entrada, con los términos que acabamos de ver explicados de forma sencilla:
Dirección IP
Es el identificador único que tiene cada dispositivo conectado a internet, algo así como su número de casa dentro de la red, y es lo que permite que la información sepa exactamente a dónde llegar. Por ejemplo, funciona como la dirección postal de tu casa, sin ella un paquete no sabría dónde entregarse, y en internet pasa lo mismo con cada dato que viaja hasta tu dispositivo.
DNS (Sistema de nombres de dominio)
Es el sistema que traduce los nombres de los sitios web, los que escribes en el navegador, a la dirección IP real del servidor donde están alojados. Por ejemplo, funciona como una agenda de contactos en tu teléfono, tú buscas el nombre de la persona y el teléfono marca automáticamente el número que corresponde, sin que tengas que memorizarlo.
Latencia
Es el tiempo que tarda un dato en viajar desde tu dispositivo hasta el servidor y volver. Por ejemplo, es parecido a una llamada con eco, mientras más lejos esté la otra persona, más tarda la voz en llegar y volver, y en internet pasa igual, mientras más lejos esté el servidor que responde, más tarda esa respuesta en regresar a tu pantalla. Justo por eso existen las ubicaciones perimetrales que vimos antes, acercar los datos al usuario final es una forma de mantener la latencia lo más baja posible.
Ancho de banda
Es la cantidad de datos que pueden viajar por una conexión en un momento dado. Por ejemplo, es como una tubería de agua, una tubería ancha deja pasar más agua al mismo tiempo, mientras que una tubería angosta limita cuánta agua puede fluir aunque la presión sea la misma, y con una conexión a internet ocurre igual con la cantidad de datos que puede transportar a la vez.
Vendor locking
Es la situación en la que una empresa queda tan atada a un proveedor de tecnología que migrar a otro resulta costoso o técnicamente muy difícil. Por ejemplo, es como comprar electrodomésticos que solo funcionan con los accesorios de una marca específica, cambiar de marca más adelante implica reemplazar todo, no solo una pieza.
Caché
Es una copia temporal de datos guardada en un lugar más cercano o más rápido de acceso, para no tener que ir hasta el origen cada vez que se necesitan. Por ejemplo, es como llevar contigo una fotocopia de un documento importante en vez de tener que ir hasta el archivo central cada vez que lo necesitas consultar.
Interoperabilidad
Es la capacidad de distintos sistemas, aunque sean de proveedores diferentes, para funcionar juntos e intercambiar información sin problemas entre sí. Por ejemplo, es como dos personas que hablan idiomas distintos pero logran comunicarse porque ambas conocen un tercer idioma en común, ese idioma compartido es lo que hace posible el intercambio.
Contenedores
Son paquetes que incluyen una aplicación junto con todo lo que necesita para funcionar, su código, sus configuraciones y sus dependencias, de forma que corra igual sin importar en qué computadora o nube se ejecute. Por ejemplo, es como una maleta que ya lleva todo lo necesario para un viaje, así no importa el hotel donde te alojes, tienes contigo todo lo que necesitas para estar cómoda.
Con esto ya tienes cubierto el primer pilar de la certificación, desde los modelos de infraestructura hasta los modelos de servicio. En la próxima entrada de la serie voy a meterme con el segundo pilar, la transformación de datos.
← Entrada anterior
Ruta hacia Google Cloud Digital Leader
Siguiente entrada →
Transformación de datos con Google Cloud